Construção e vocabulário
Importe Tokenizer da raiz; pre_tokenize, SPACE, SPECIALS e UNK_TEXT vêm de glassllm.tokenizer. Tokenizer(alphabet: list[str], merges: list[tuple[str,str]]) constrói um vocabulário com tokens especiais, alfabeto e resultados das fusões, nessa ordem. O construtor copia as listas; ele não aprende fusões nem valida todas as combinações possíveis de um vocabulário manual.
| Atributo ou constante | Conteúdo |
|---|---|
SPECIALS |
["<pad>", "<unk>", "<bos>", "<eos>"], IDs 0–3 |
SPACE |
"▁", representa um espaço ASCII |
UNK_TEXT |
"⁇", texto usado ao decodificar <unk> |
alphabet, merges |
Caracteres e pares aprendidos, em ordem |
ranks |
Dicionário par → prioridade da fusão |
vocab |
Lista completa de strings por ID |
token_to_id, unk_id |
Dicionário inverso e ID do desconhecido, normalmente 1 |
vocab_size |
Propriedade inteira, len(vocab) |
vocab_size é uma propriedade: use tok.vocab_size, sem parênteses. Para ler strings por ID, use tok.tokens(ids) ou tok.vocab[id]. Não existe método id_to_token.
Normalização e aprendizagem
pre_tokenize(text: str) -> list[str] normaliza Unicode para NFC, troca cada espaço ASCII por ▁ e separa chunks. Quebras de linha são chunks individuais; espaços anteriores à palavra ficam no mesmo chunk dela. Fusões não atravessam chunks. Outros tipos de espaço, como tabulação, não são todos convertidos para ▁. Um ▁ literal é interpretado como marcador, portanto não há reversibilidade irrestrita para qualquer string Unicode.
Tokenizer.train(text: str, vocab_size: int) -> Tokenizer conta chunks, começa pelo alfabeto observado e escolhe o par adjacente mais frequente. Empates são resolvidos pela ordem alfabética do par; cada fusão é aplicada sem sobreposição. O pedido deve comportar quatro especiais mais o alfabeto, ou ocorre ValueError. O tamanho pedido é um teto: corpora pequenos podem esgotar pares antes de alcançá-lo.
from glassllm import Tokenizer
from glassllm.tokenizer import pre_tokenize

assert pre_tokenize("Olá mundo\n") == ["Olá", "▁mundo", "\n"]
tok = Tokenizer.train("banana banana\n", vocab_size=32)
ids = tok.encode("banana banana\n")
assert tok.decode(ids) == "banana banana\n"
assert tok.vocab_size <= 32
assert len(tok.tokens(ids)) == len(ids)
assert tok.encode("🧪") == [tok.unk_id]
assert tok.decode([tok.unk_id]) == "⁇"
Codificar e explicar as fusões
encode(text: str) -> list[int] percorre cada chunk e aplica primeiro a fusão disponível de menor rank. Cada peça ausente do vocabulário vira unk_id. Não insere padding, BOS ou EOS e não limita o comprimento. Entrada vazia gera [], que não é um prompt válido para GlassLM.generate.
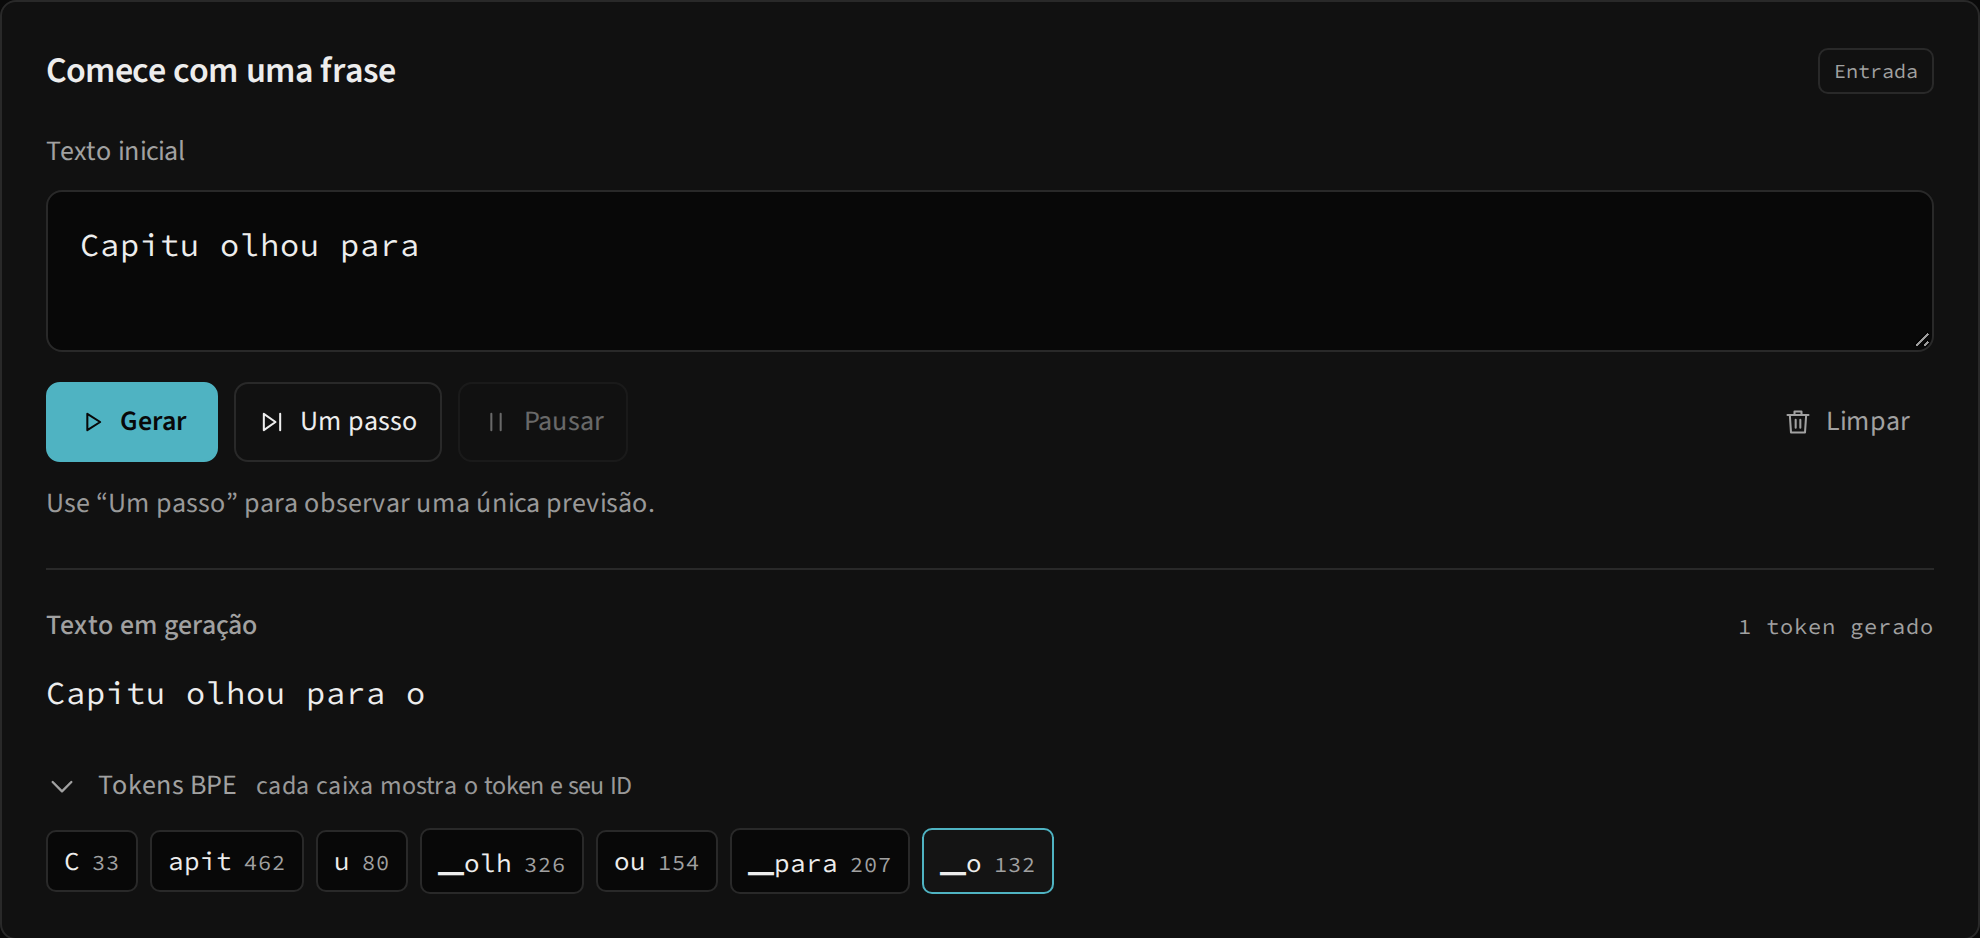
encode_verbose(text: str) -> list[dict] devolve uma entrada por chunk: {"chunk": str, "steps": list[list[str]]}. O primeiro estado contém os caracteres; os seguintes contêm as peças após cada fusão aplicada. Não são IDs nem probabilidades, e um chunk sem fusões ainda tem seu estado inicial. Esta chamada preserva os estados para explicação mesmo quando a codificação normal pode usar o cache interno.
from glassllm import Tokenizer

tok = Tokenizer.train("banana banana\n", 32)
detail = tok.encode_verbose("banana")
assert detail[0]["chunk"] == "banana"
assert detail[0]["steps"][0] == list("banana")
assert detail[0]["steps"][-1] == tok.tokens(tok.encode("banana"))
Tokens e texto
tokens(ids: list[int]) -> list[str] consulta vocab com indexação Python. IDs acima do limite produzem IndexError; índices negativos seguem a semântica da lista e não são rejeitados, portanto valide IDs externos. decode(ids: list[int]) -> str concatena peças, converte ▁ em espaços, transforma <unk> em ⁇ e omite os outros três especiais. Ele não reconstrói texto que foi perdido por normalização ou desconhecidos.
Salvar e carregar
save(path: str | Path) -> None escreve JSON UTF-8 com version: 1, alphabet e merges; sobrescreve o destino e não cria diretórios pais. Tokenizer.load(path: str | Path) -> Tokenizer lê essas listas e reconstrói ranks e vocabulário. O leitor atual não negocia versões nem valida um esquema completo: ausência de chaves gera KeyError, JSON inválido gera erro do leitor e problemas de arquivo geram OSError.
from pathlib import Path
from tempfile import TemporaryDirectory
from glassllm import Tokenizer

tok = Tokenizer.train("banana banana\n", 32)
with TemporaryDirectory() as directory:
    path = Path(directory) / "tokenizer.json"
    tok.save(path)
    restored = Tokenizer.load(path)
    assert restored.encode("banana") == tok.encode("banana")
    assert restored.vocab == tok.vocab
Relação com os artigos
O projeto usa a ideia de fusões BPE para subpalavras descrita por Sennrich, Haddow e Birch. A implementação começa por caracteres Unicode, não bytes, e não tem byte fallback. O marcador visual de espaços lembra SentencePiece, mas este é um tokenizer próprio: não carrega modelos SentencePiece nem implementa seu conjunto de algoritmos. Veja Tokens e BPE para acompanhar o cálculo.