Dois espaços de escolha
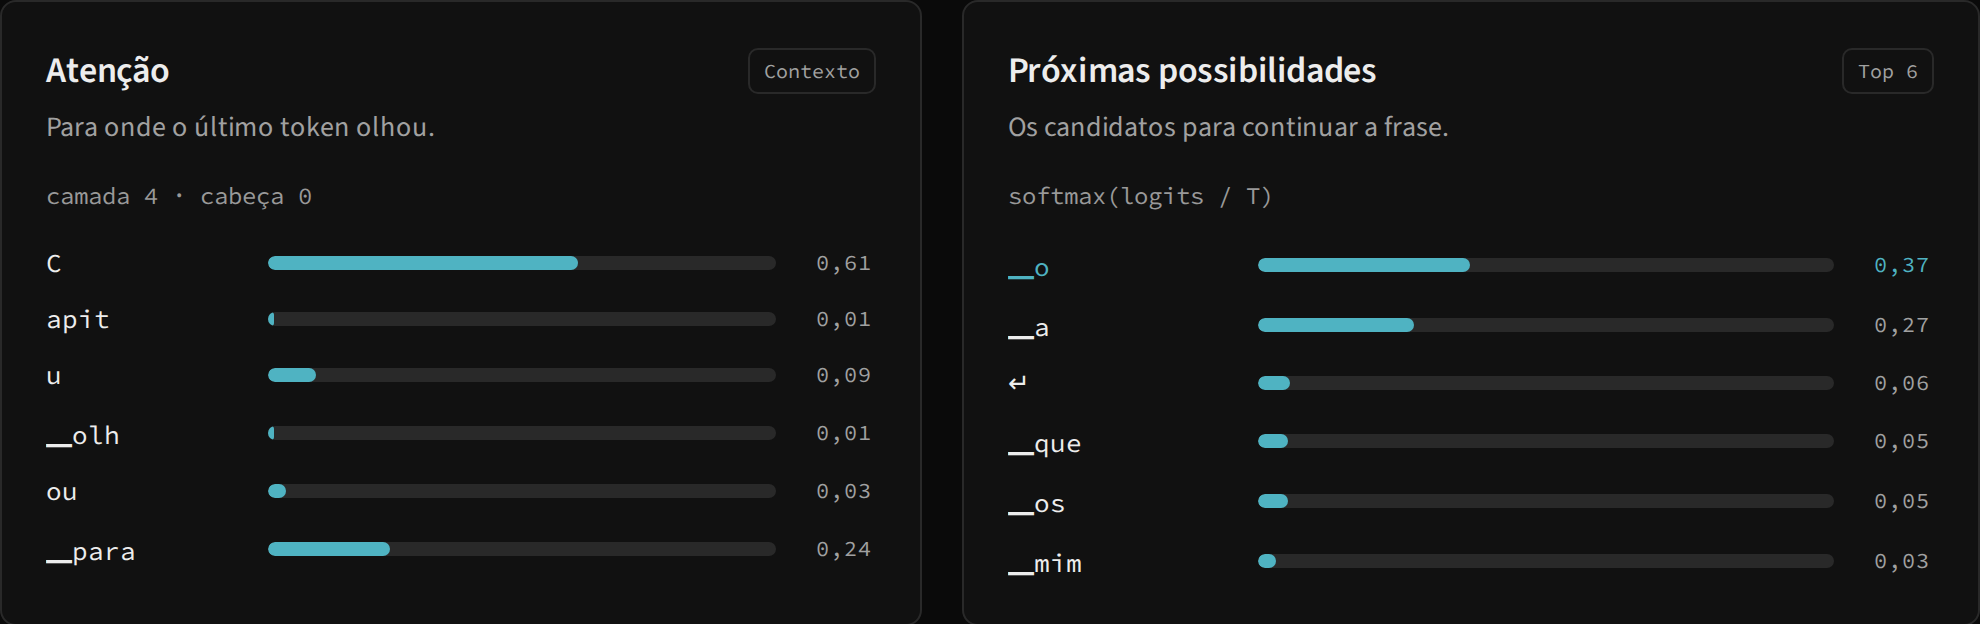
Atenção distribui pesos entre posições do contexto para misturar os vetores V dentro de uma cabeça. Próximas possibilidades distribui probabilidades entre IDs do vocabulário para escolher a próxima saída. Embora ambos envolvam softmax, não têm o mesmo eixo, significado nem finalidade.
| Painel | Eixo das barras | Origem do valor | Abrangência |
|---|---|---|---|
| Atenção | Tokens presentes no contexto da previsão | Última linha de attn.softmax, bloco de índice 3, cabeça de índice 0 |
Uma cabeça do último bloco |
| Próximas possibilidades | Tokens candidatos do vocabulário | GenStep.probs |
Os seis maiores valores entre 1.024 IDs |
Ler o painel de atenção
Depois de uma previsão, cada linha apresenta um token do contexto, uma barra e um peso arredondado a duas casas. A indicação camada 4 · cabeça 0 usa o número humano da camada e o índice Python da cabeça. No inspetor completo, a mesma cabeça aparece no seletor como Cabeça 1.
Os pesos dizem como a consulta da última posição mistura valores das posições acessíveis naquela cabeça. Eles somam aproximadamente 1 antes do arredondamento. Números exibidos como 0,00 podem ser pesos positivos pequenos; a barra não exige que o valor seja exatamente zero.
Isso é uma visão parcial do cálculo. Outra cabeça ou outro bloco pode usar distribuição diferente. Uma barra grande não prova que um token, isoladamente, determinou a palavra escolhida: depois dessa mistura existem outras operações, blocos, resíduos e a projeção de saída.
O token recém-escolhido ainda não fez parte do contexto dessa previsão. Ele é acrescentado depois e influencia a previsão seguinte. Por isso o painel descreve as posições usadas para decidir a continuação, não o texto inteiro já atualizado na saída.
Ler os seis candidatos
O worker ordena a distribuição completa e mostra os seis IDs de maior probabilidade. As barras usam a probabilidade original, sem renormalizar os seis valores. Assim, somar as seis barras normalmente resulta em menos que 1; o restante pertence aos demais tokens do vocabulário.
A temperatura já está aplicada: os valores correspondem a softmax(logits / T) da rodada. No modo Mais provável, o ID de maior valor é escolhido. No modo Sortear, o ID escolhido pode estar fora desses seis, pois o sorteio usa toda a distribuição.
Os rótulos são formas BPE, não palavras completas. Um candidato ▁o acrescenta o; uma parte como ning continua uma palavra. Tokens especiais podem aparecer entre os candidatos e não gerar texto visível. O painel mostra probabilidade de ID, sem um filtro que force a saída a ser uma palavra.
Um exercício de comparação
- Limpe a rodada, mantenha a frase padrão e escolha Mais provável.
- Gere um token e registre o primeiro candidato.
- Leia a linha de maior peso no contexto e confira que ela pertence à entrada.
- Abra a arquitetura e selecione Softmax da atenção no quarto bloco.
- Compare Cabeça 1 e Cabeça 2 no inspetor. A lista resumida continua fixa na primeira cabeça.
- Reinicie com outra temperatura e observe os candidatos de saída.
O print attention.png captura as duas listas depois de uma previsão real e pausada. Para a matriz completa, use o inspetor: ele mostra o shape inteiro e um recorte de até 8 × 8. Para os cálculos que geram esses pesos, leia atenção causal.