Consultar o contexto
A atenção produz um vetor para cada posição combinando os conteúdos que ela pode observar. Q representa a consulta da posição atual, K representa as chaves com as quais essa consulta é comparada e V contém os valores misturados. São projeções aprendidas distintas; os nomes são uma analogia para o cálculo, não perguntas ou etiquetas escritas em linguagem natural.
Em Attention.__call__, de src/glassllm/nn.py, a entrada já foi normalizada pela RMSNorm do bloco. A sequência é:
X → Q/K/V → RoPE em Q/K → cache → expansão GQA
  → QKᵀ/√dₖ → máscara causal → softmax → mistura com V → W_O
Dimensões reais
Use B para batch, n para consultas novas e m para chaves totais. Sem cache, m=n; com cache, m=start+n.
| Etapa | Dimensões padrão |
|---|---|
| Entrada X | (B, n, 128) |
| W_Q / W_K / W_V | (128,128) / (128,64) / (128,64) |
| Q por cabeça | (B, 4, n, 32) |
| K/V antes de GQA | (B, 2, m, 32) |
| K/V após repeat_kv | (B, 4, m, 32) |
| Scores e pesos | (B, 4, n, m) |
| Mistura por cabeça | (B, 4, n, 32) |
| Concatenação / saída | (B, n, 128) |
O código aplica RoPE antes de inserir as novas chaves no cache. GQA compartilha duas cabeças K/V entre quatro cabeças Q. W_O, com shape (128,128), combina as saídas concatenadas; todas essas projeções não têm bias.
Scores, máscara e normalização
S[h,i,j] = dot(Q[h,i], K[h,j]) / sqrt(32)
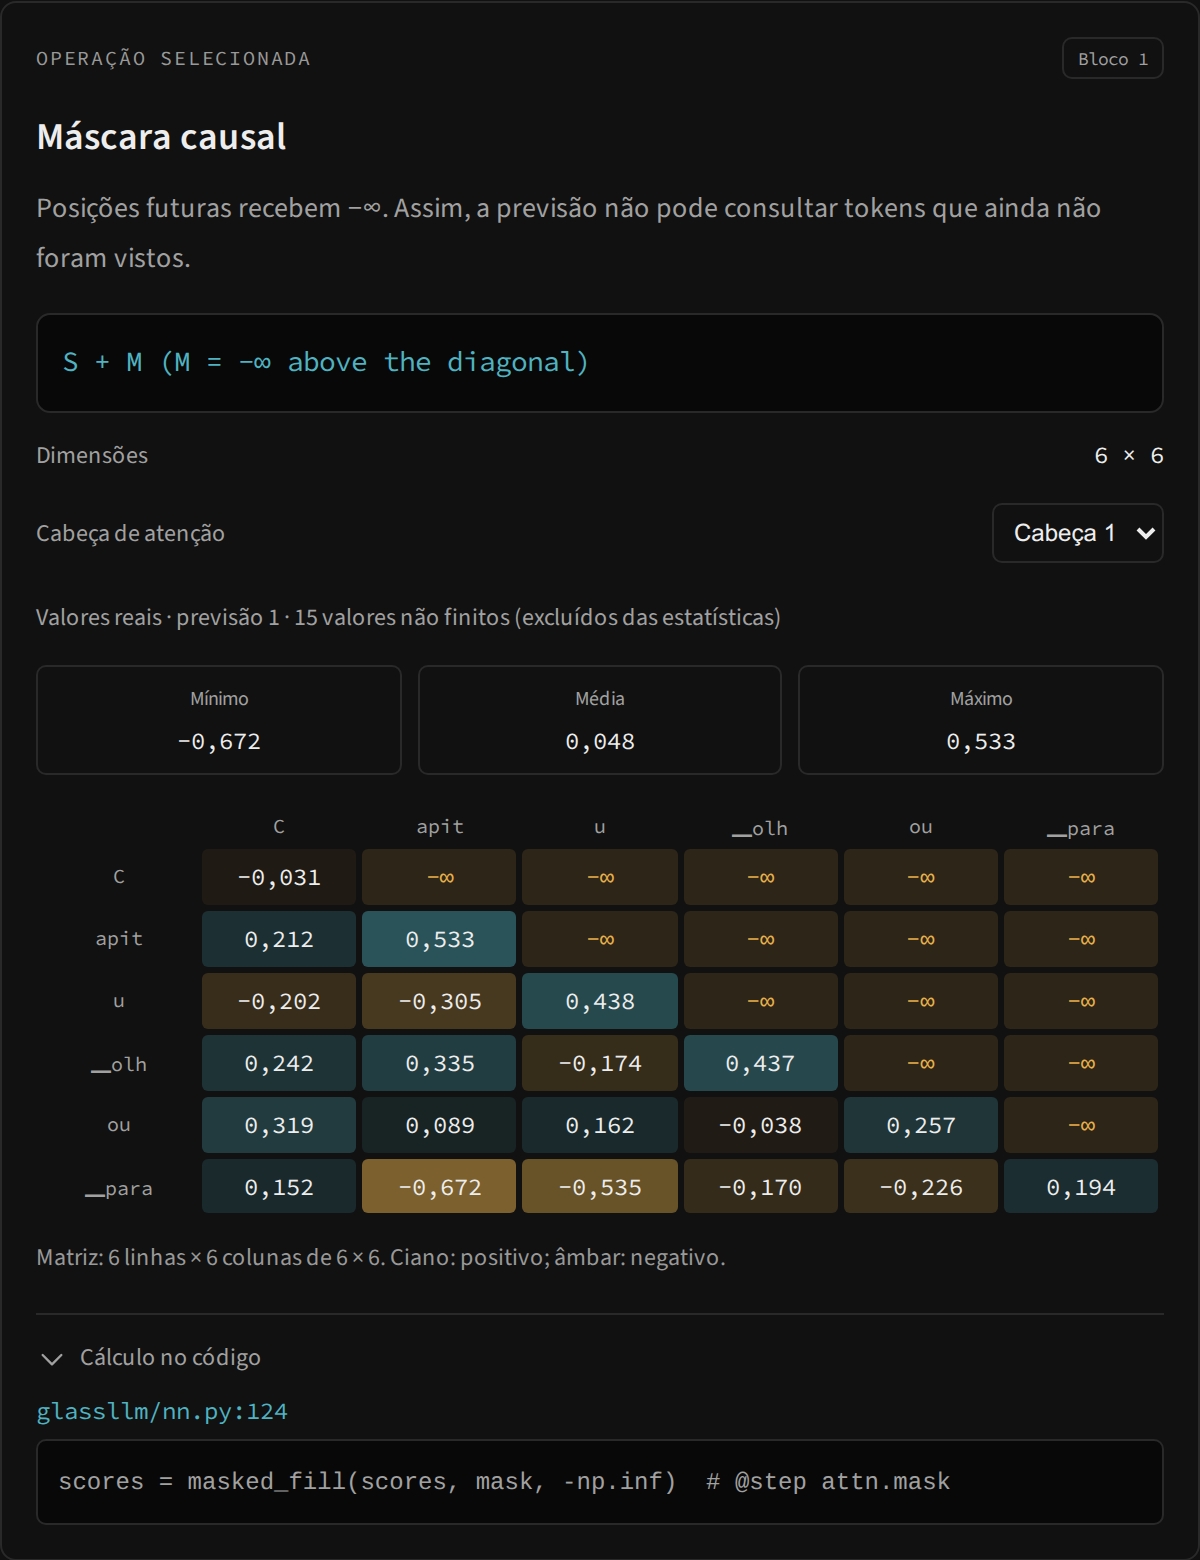
M[i,j] = −∞ se j > start+i; 0 caso contrário
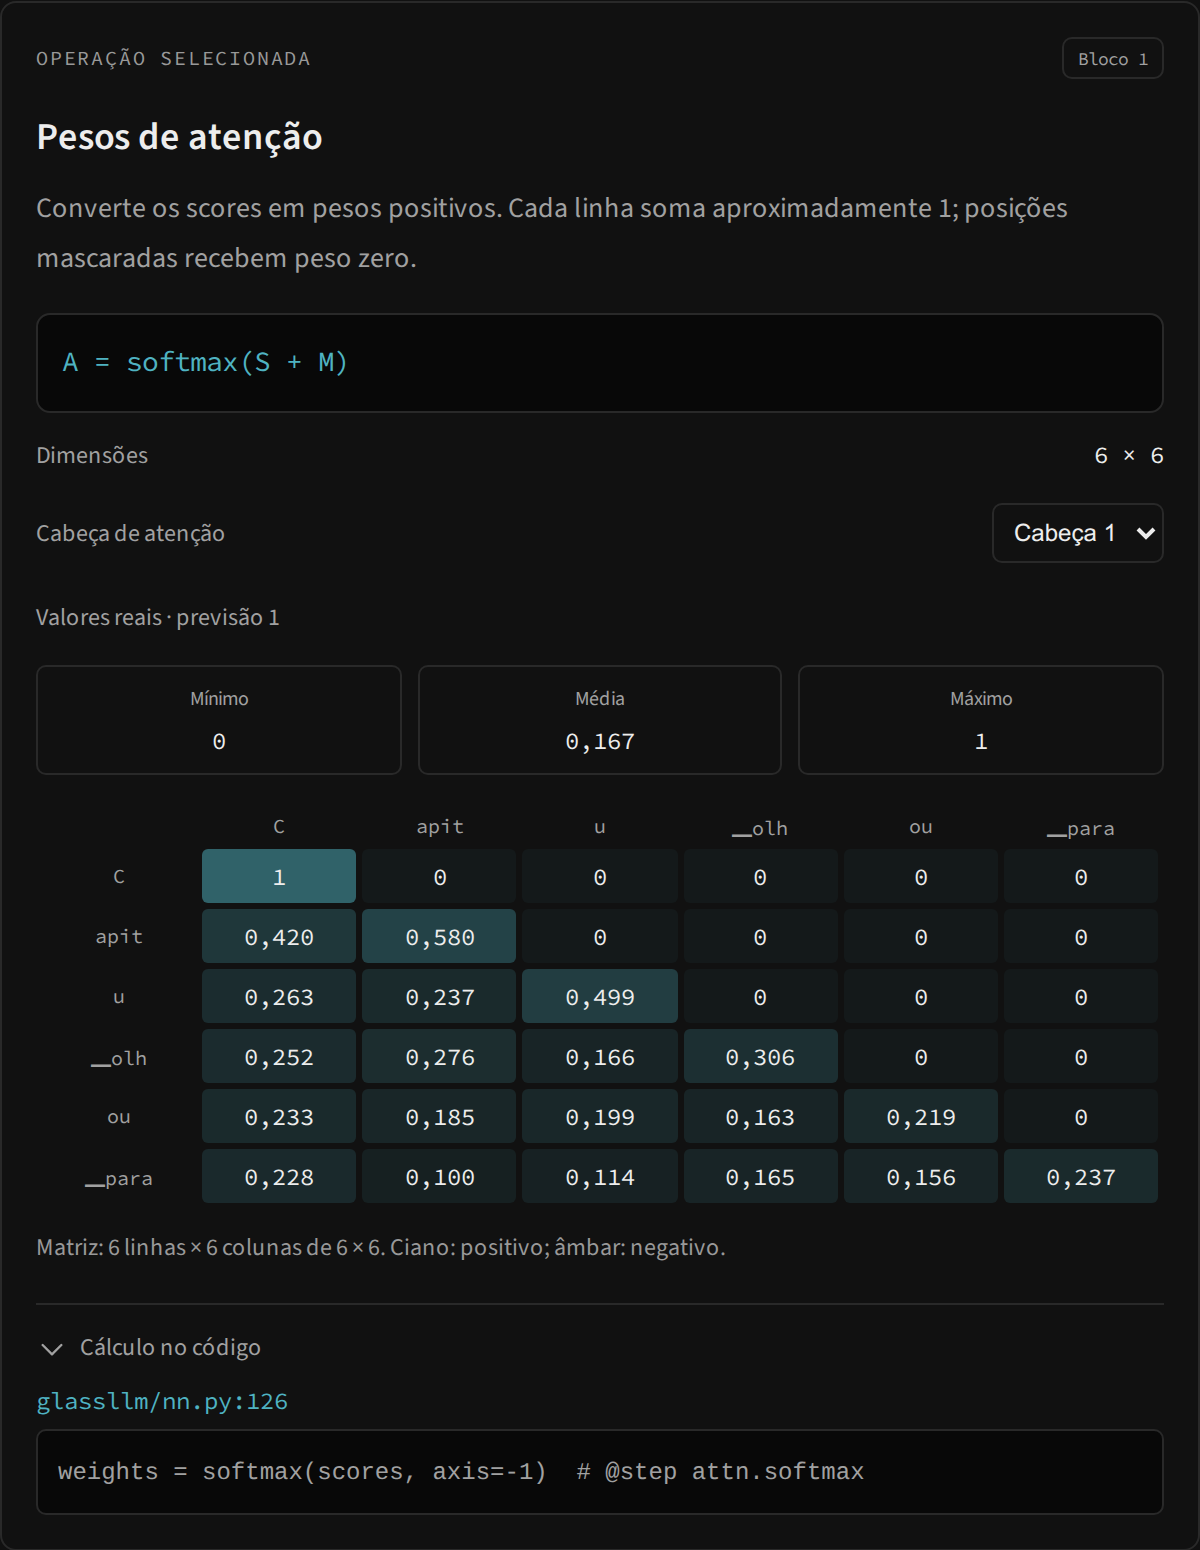
A[h,i,:] = softmax(S[h,i,:] + M[i,:])
Y[h,i,:] = Σ_j A[h,i,j] · V[h,j,:]
O divisor √dₖ controla a escala dos produtos escalares. Sob a hipótese didática de coordenadas independentes com média zero e variância um, a variância do produto escalar é dₖ; a divisão a normaliza. Essa hipótese explica o fator, mas não descreve exatamente os vetores aprendidos.
causal_mask(n, m, start) retorna True nas posições proibidas. masked_fill substitui os scores por −∞. Como exp(−∞)=0, o futuro recebe peso zero. O softmax subtrai o máximo da linha antes de exponenciar, preservando a distribuição e reduzindo risco de overflow. Cada linha válida soma aproximadamente 1, respeitando o arredondamento numérico.
Exemplo numérico completo
Este exemplo usa uma cabeça de dimensão 2 para tornar a conta curta:
import numpy as np
from glassllm.nn import causal_mask
from glassllm.autograd import softmax_np

Q = np.array([[1., 0.], [1., 1.], [0., 1.]])
K = Q.copy()
V = np.array([[2., 0.], [0., 2.], [2., 2.]])
scores = Q @ K.T / np.sqrt(2)
masked = np.where(causal_mask(3, 3, 0), -np.inf, scores)
weights = softmax_np(masked)
print(np.round(weights, 6))
print(np.round(weights @ V, 6))
Saída verificada:
Pesos: [[1.000000, 0.000000, 0.000000],
        [0.330238, 0.669762, 0.000000],
        [0.197776, 0.401112, 0.401112]]
Saída: [[2.000000, 0.000000],
        [0.660477, 1.339523],
        [1.197776, 1.604448]]
A primeira posição só observa a si mesma. A segunda mistura as duas primeiras linhas de V. A terceira usa todo o prefixo. O exemplo começa depois das projeções e não inclui RoPE nem W_O.
Ler os snapshots sem confundir significados
O inspetor oferece attn.q, attn.k, attn.v, attn.rope_q, attn.rope_k, attn.scores, attn.mask, attn.softmax, attn.mix e attn.out. Escolha camada 0–3; Q e os pesos têm quatro cabeças, K/V projetados têm duas. O Tracer remove o batch, por isso uma cabeça selecionada de attn.softmax aparece como (n,m).
Os pesos da atenção medem a mistura de contexto dentro da cabeça. As probabilidades de saída distribuem massa entre os 1.024 candidatos a próximo token. Peso de atenção alto não é prova isolada de causalidade ou uma explicação completa da previsão.
Referência
A atenção por produto escalar escalado e sua máscara no decoder aparecem em Attention Is All You Need, Vaswani et al., 2017. Este projeto usa um decoder com RMSNorm, RoPE, GQA e SwiGLU; não reproduz integralmente a arquitetura encoder–decoder original.