Comece pelo caminho principal
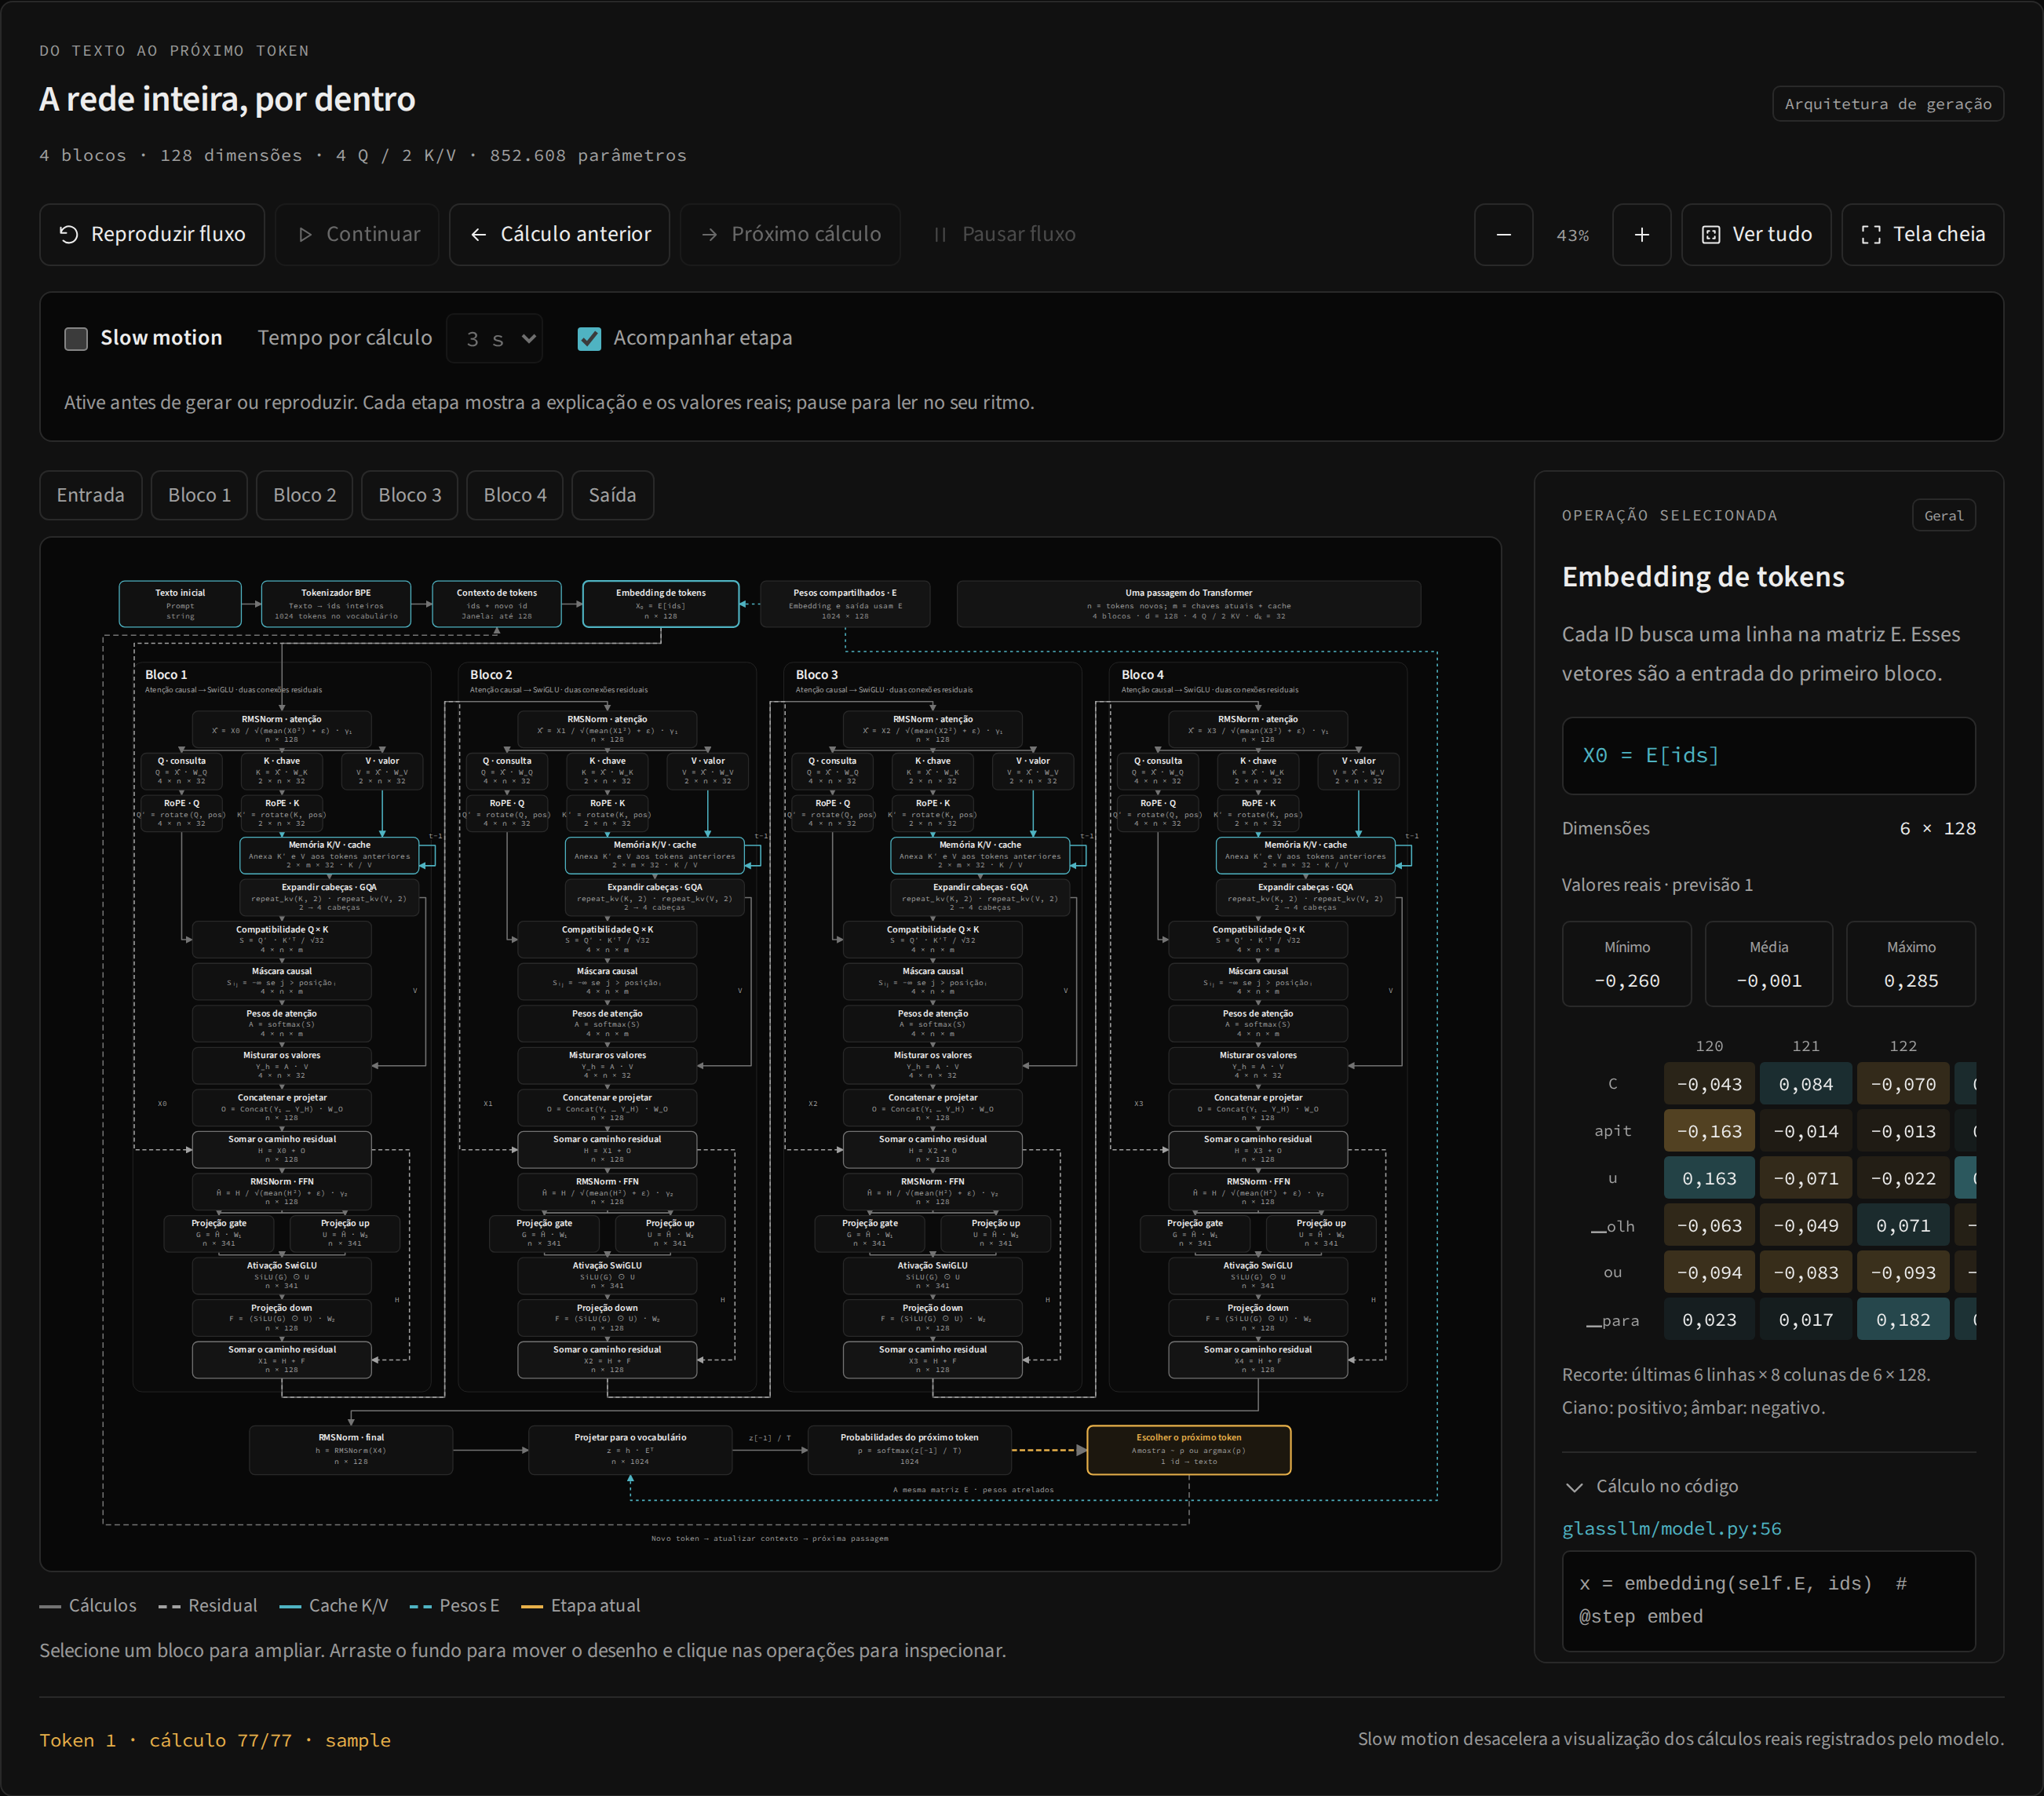
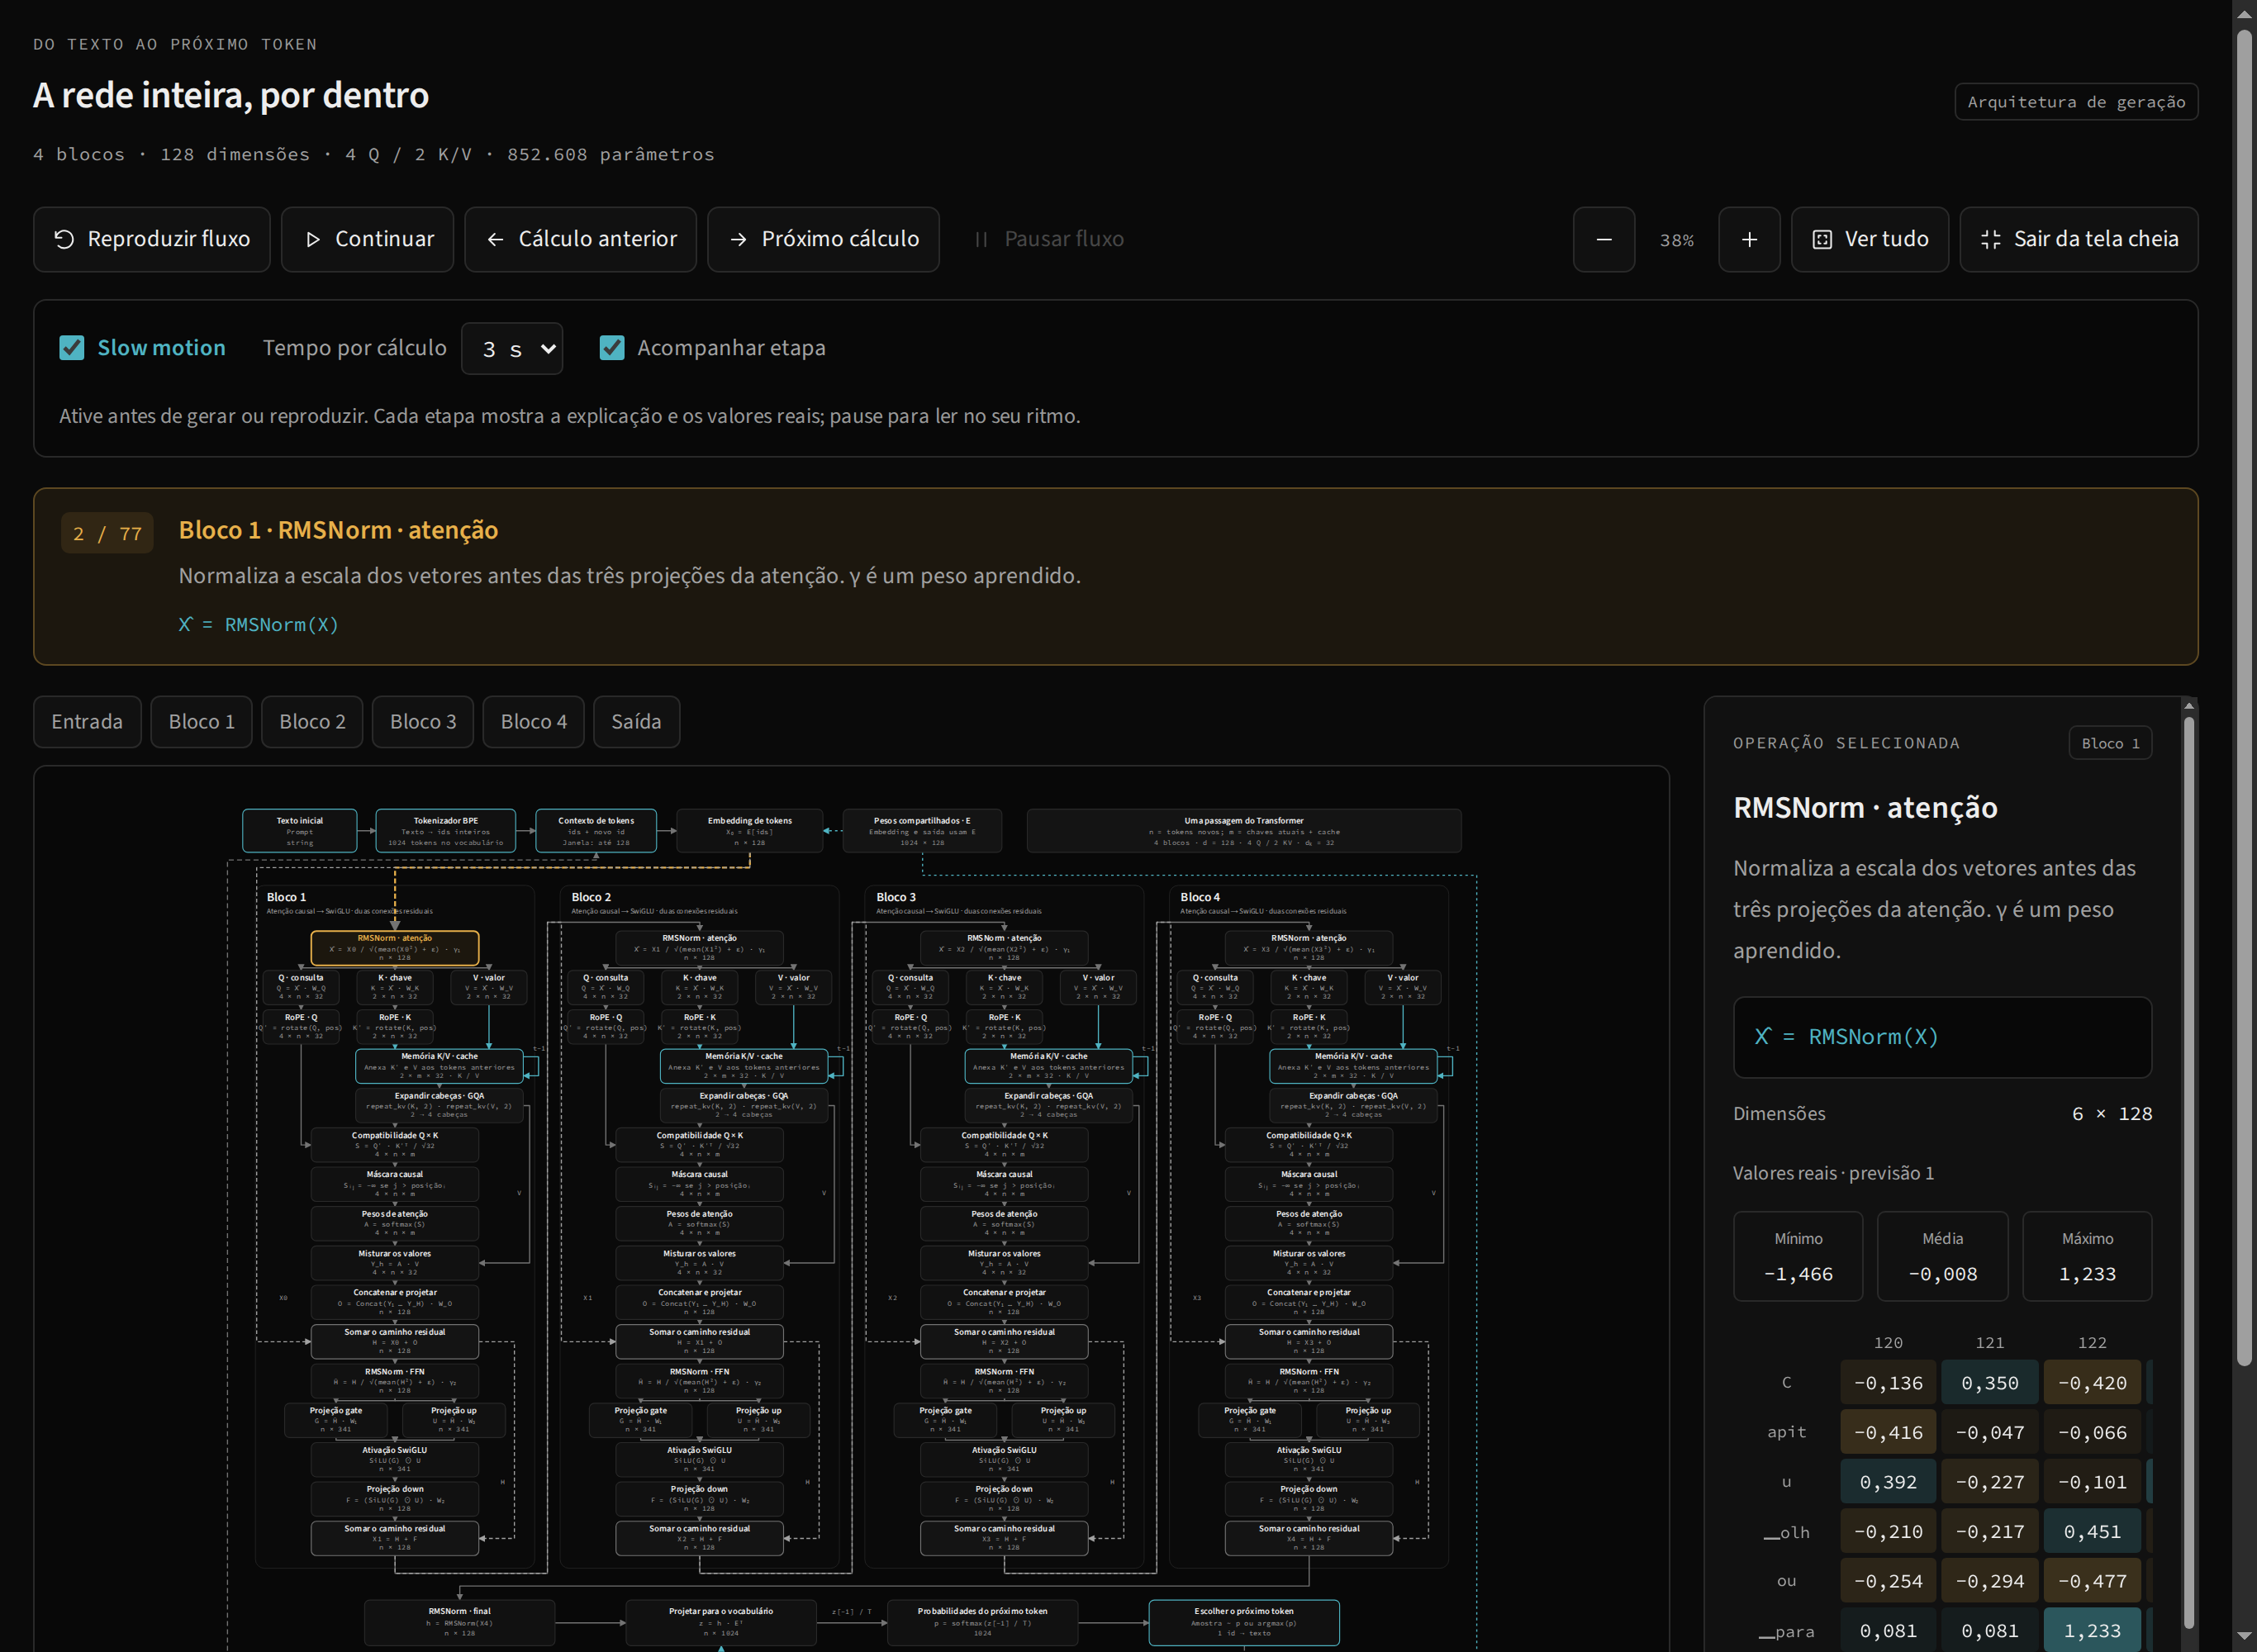
Ver rede completa leva ao mapa da previsão. Ele contém entrada textual, tokenização, contexto, embedding, quatro blocos Transformer, RMSNorm final, logits, probabilidades, escolha e o retorno do ID ao contexto. A topologia padrão tem 90 nós e 118 conexões; 77 desses passos correspondem aos eventos registrados em uma geração.
Use Ver tudo para reconhecer as áreas e depois Entrada, Bloco 1–4 ou Saída para ampliar uma região. O desenho mostra geração por um decoder causal; os cálculos de perda e backward usados no treinamento não integram esse percurso de previsão.
Ler um bloco
Cada bloco tem dois trechos, com normalização antes de cada transformação:
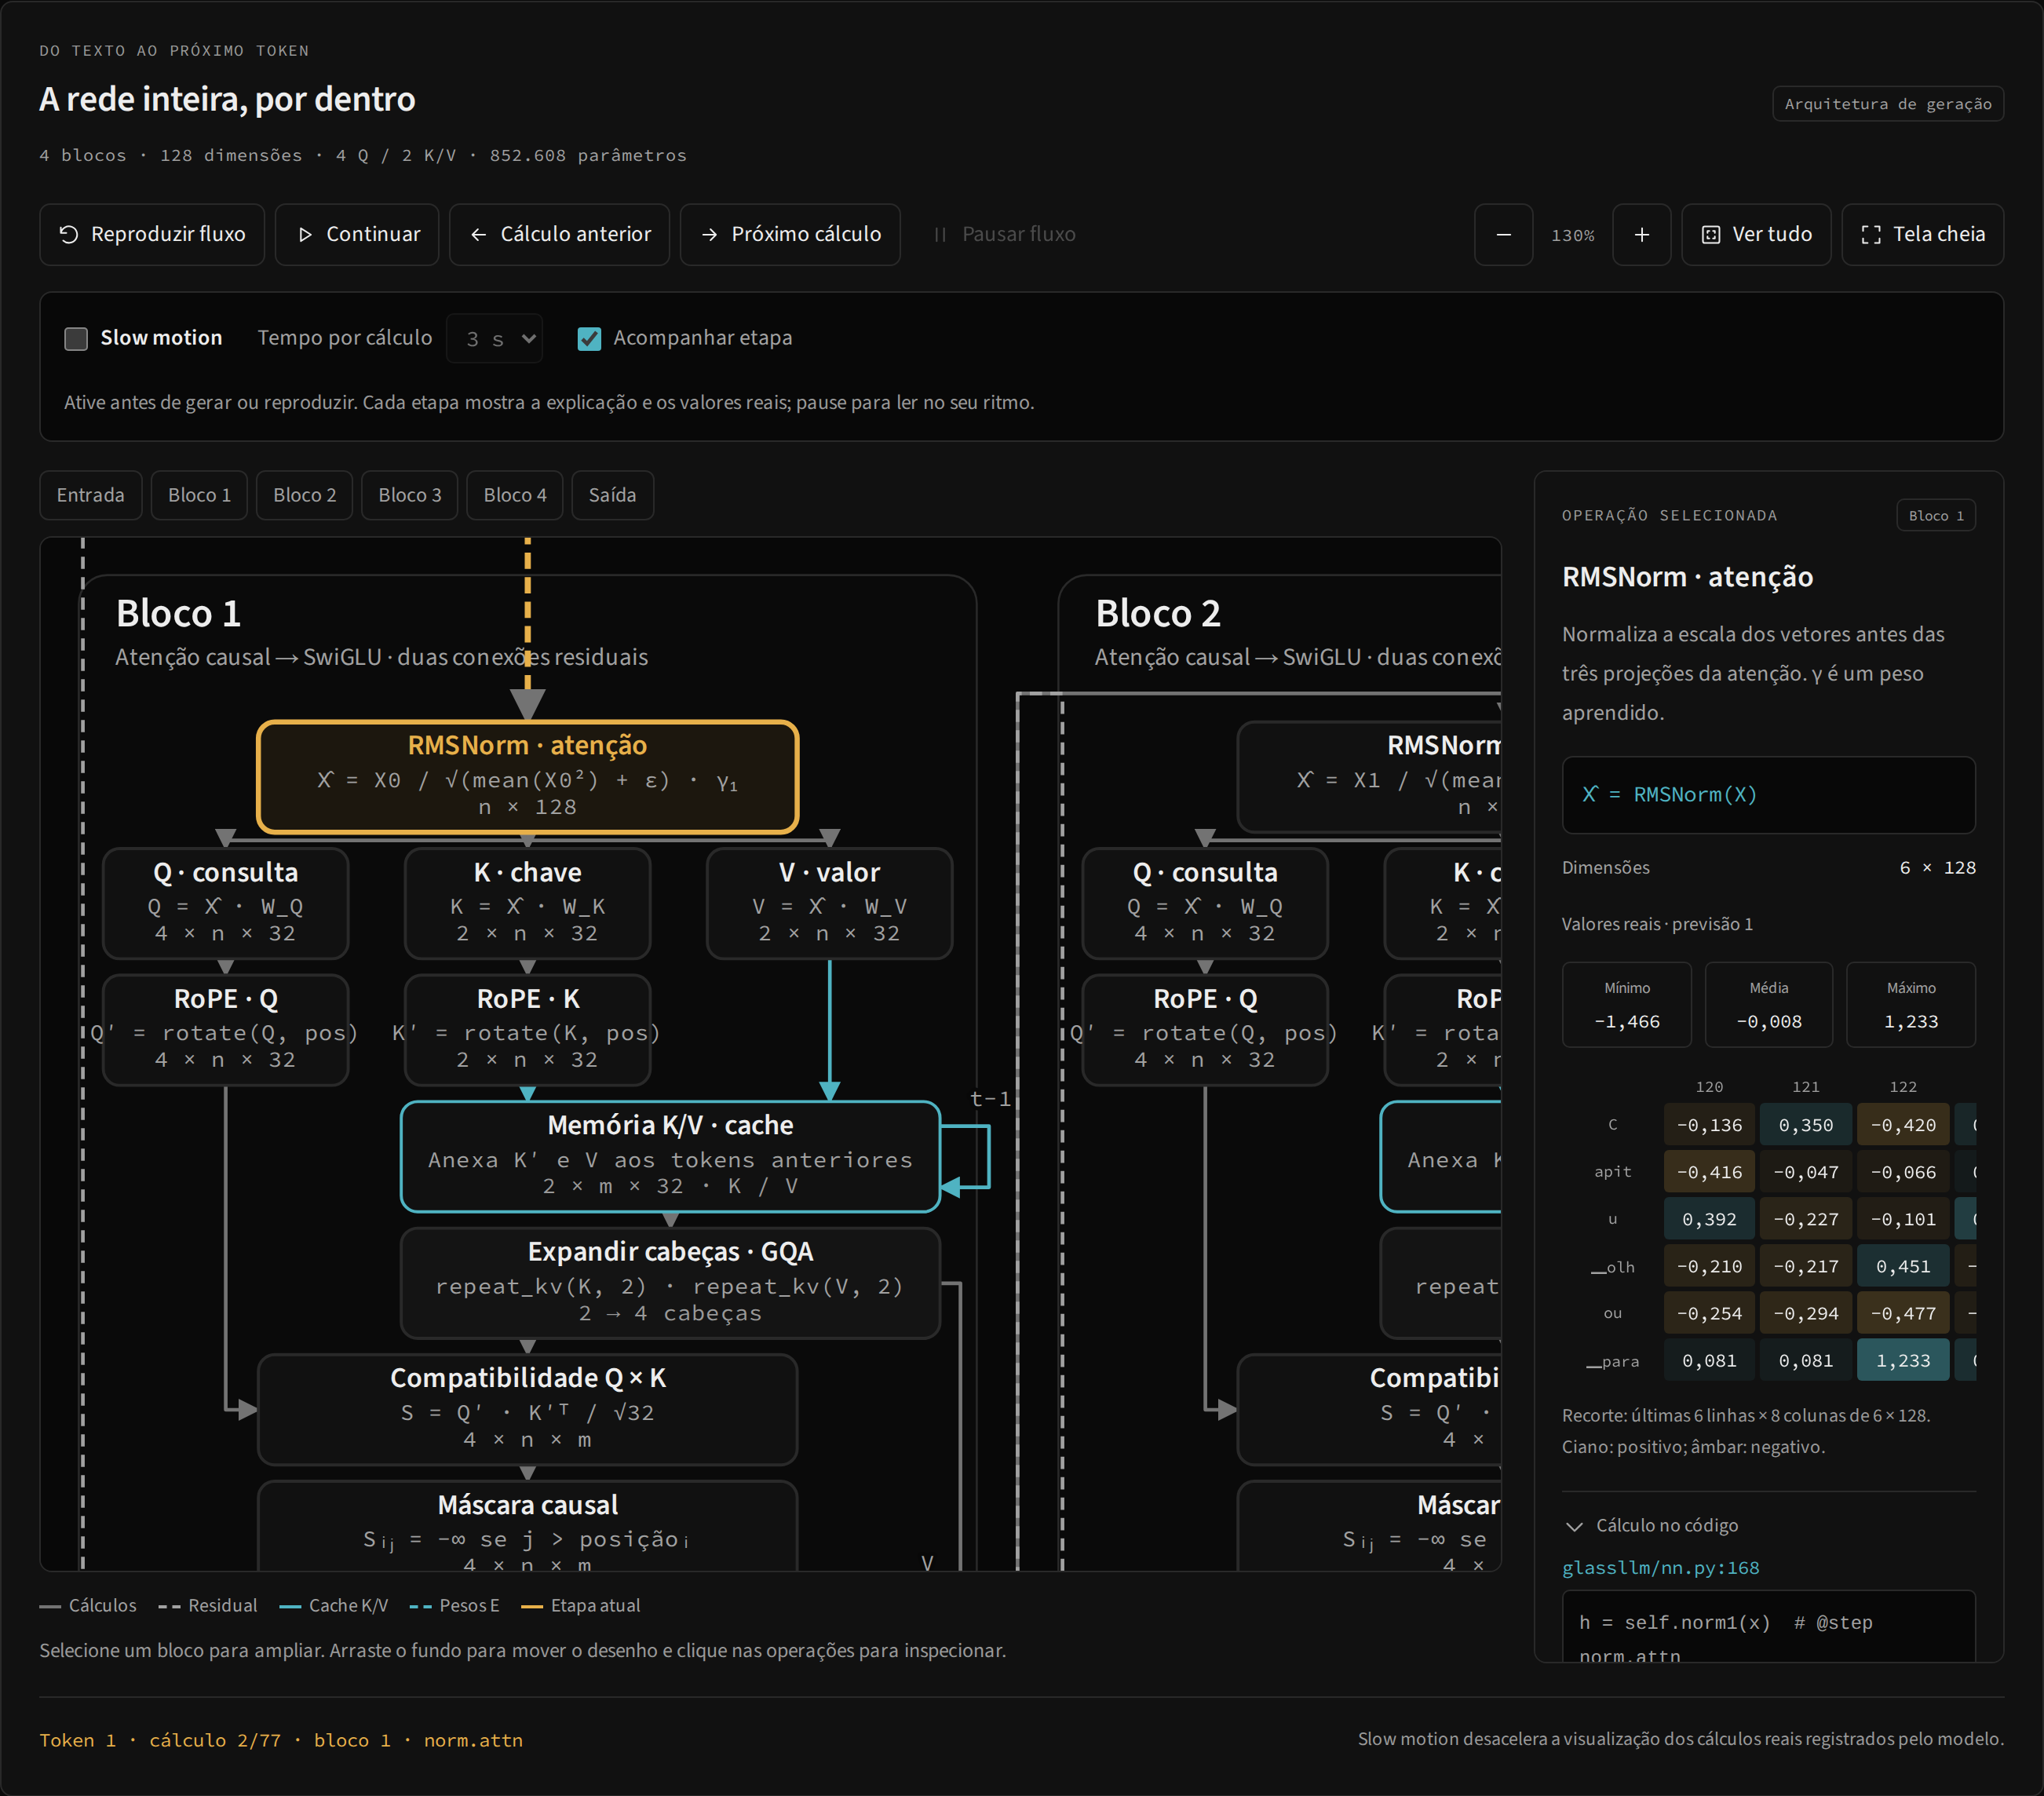
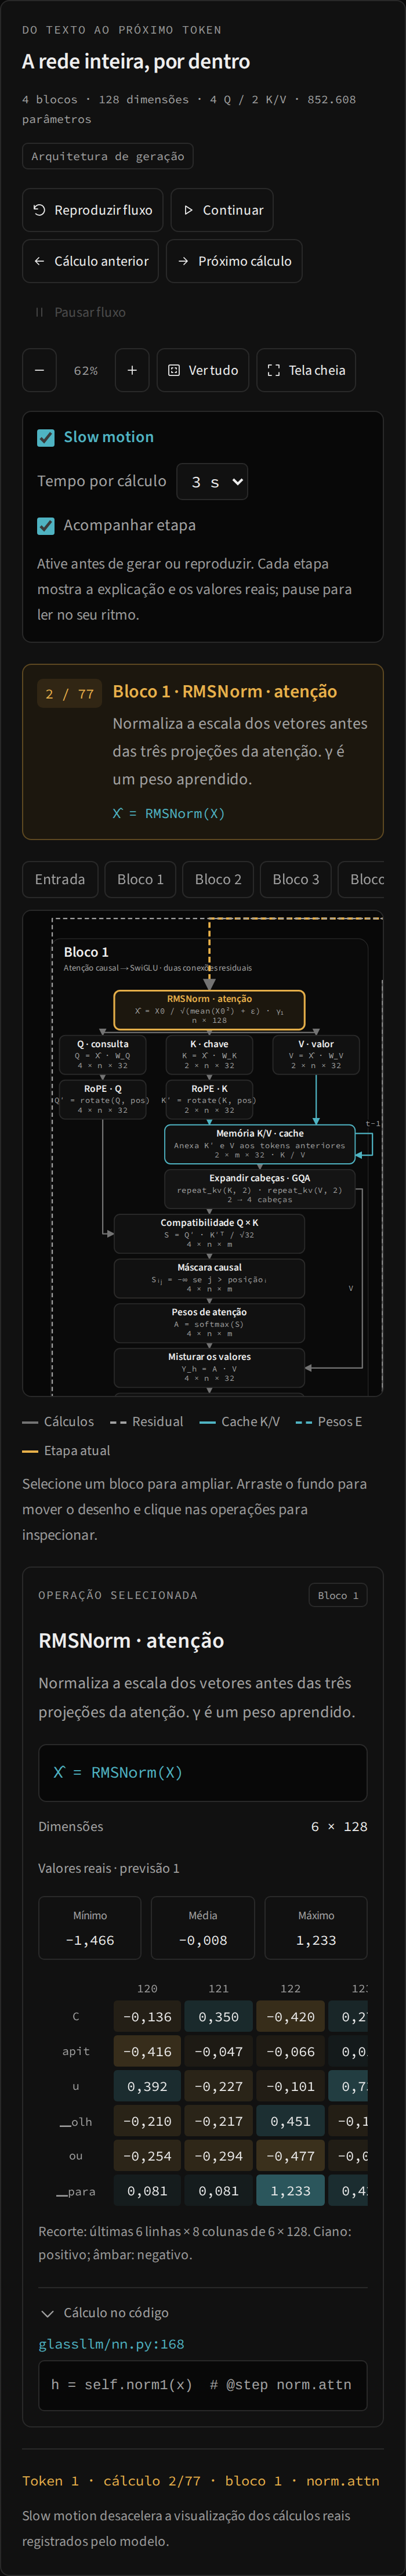
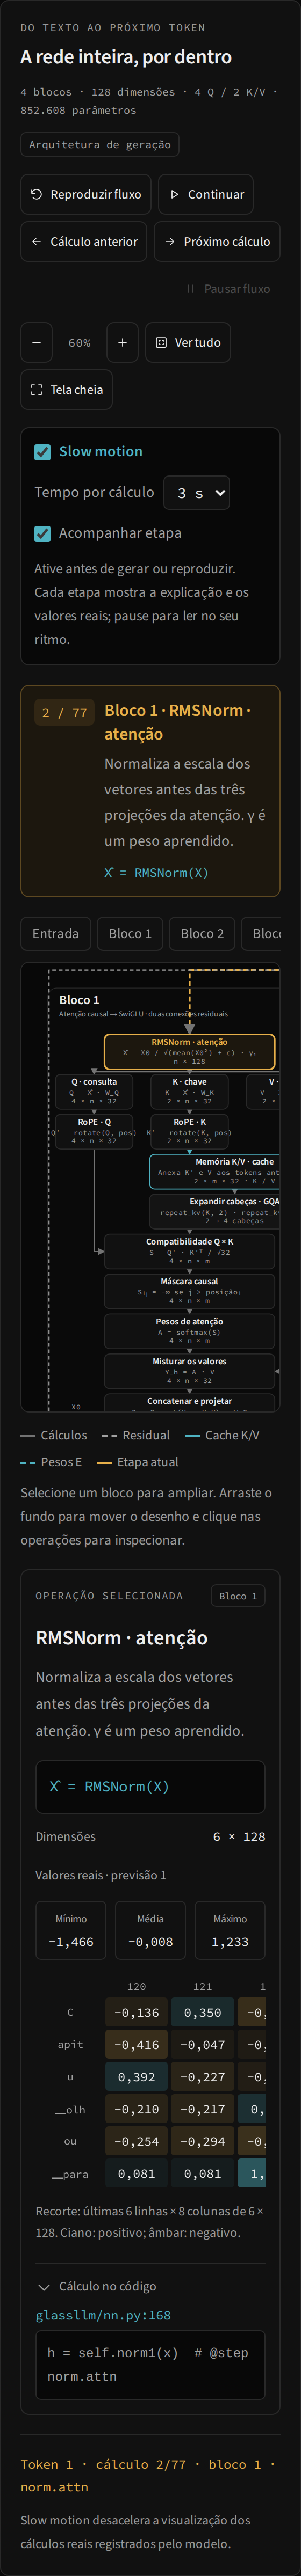
- A entrada passa por RMSNorm e se divide nas projeções Q, K e V.
- Q e K recebem RoPE. K após RoPE e V alimentam o cache do bloco.
- GQA disponibiliza as duas cabeças K/V para as quatro cabeças Q.
QKᵀ / √dₖproduz scores; a máscara bloqueia o futuro; softmax transforma scores em pesos.- Os pesos misturam V; as cabeças são reunidas e projetadas com
W_O. - A primeira soma residual adiciona a entrada original à saída da atenção.
- Outra RMSNorm alimenta os ramos gate e up da FFN.
- SwiGLU calcula
SiLU(gate) ⊙ up; down volta a 128 dimensões. - A segunda soma residual preserva a entrada da FFN e entrega o resultado ao bloco seguinte.
As ramificações são necessárias para explicar que Q, K e V vêm da mesma entrada normalizada e que os resíduos transportam informação ao redor das transformações. A reprodução percorre a ordem registrada pelo código; não representa execução paralela de ramos.
Reconhecer as conexões especiais
| Legenda | Relação mostrada |
|---|---|
| Cálculos | Dependências do percurso de uma previsão |
| Residual | Soma de um estado anterior com a transformação seguinte |
| Cache K/V | Reuso de chaves rotacionadas e valores de posições anteriores |
| Pesos E | A mesma matriz na entrada e na projeção de logits |
| Etapa atual | Operação destacada na reprodução ou na seleção |
A matriz E tem formato 1024 × 128. A entrada usa E[ids]; a saída usa h @ Eᵀ. O cache é separado por bloco. GQA compartilha pesos K/V entre consultas; repetir cabeças para o produto de atenção não cria novas matrizes aprendidas.
Dimensões mudam durante a geração
O desenho usa n para posições calculadas no avanço atual e m para posições disponíveis nas chaves. No primeiro token previsto, o modelo calcula o prefixo inteiro e normalmente n = m. Nos avanços com cache, n = 1 e m cresce com o contexto.
Uma cabeça Q tem formato n × 32; uma cabeça de scores ou de pesos tem formato n × m. Ao encher a janela de 128 tokens, o motor reconstrói o cache para a janela mais recente. Por isso voltar a ver várias linhas não significa que a visualização perdeu o cache: pode ser uma reconstrução legítima.
Zoom, deslocamento e seleção
Use + / − para mudar a escala, Ver tudo para ajustar o grafo e as abas de bloco para localizar regiões. No desktop, arraste o fundo com o mouse; no celular, role o mapa. Tela cheia amplia a área disponível quando o navegador permite; Esc sai desse modo.
Clique numa operação para abrir seus valores. Essa seleção pausa a continuidade da geração e o fluxo visual. Os nós também podem receber foco e ser ativados com Enter ou Espaço. Acompanhar etapa move a janela durante o slow motion; desmarque para estudar uma região fixa.
Cache, GQA, contexto e pesos compartilhados são nós estruturais, sem snapshot independente. O inspetor descreve sua função e dimensões simbólicas; não inventa uma matriz para eles. Veja inspetor para os limites dos valores e slow motion para percorrer cada evento.