Transformar logits em probabilidades
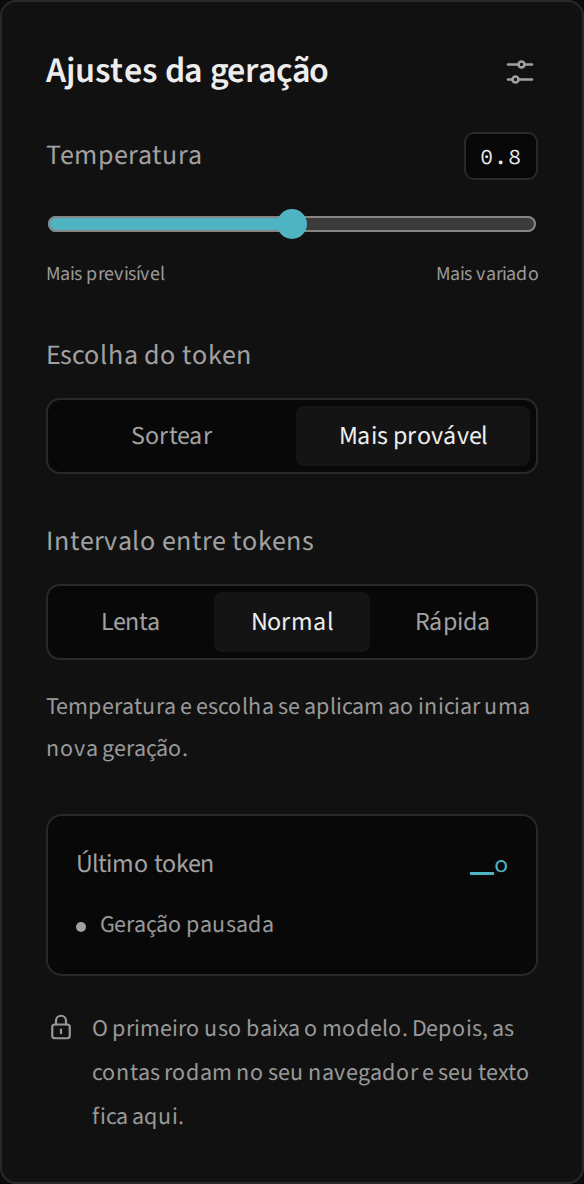
O modelo produz um logit para cada ID do vocabulário. A distribuição utilizada na geração é p = softmax(logits / T), com temperatura positiva T. No laboratório, o slider vai de 0.2 a 1.4, em passos de 0.1; o valor inicial é 0.8.
Temperaturas menores concentram a distribuição nos logits maiores. Temperaturas maiores a tornam mais distribuída. Isso muda as probabilidades de escolha, mas não os pesos treinados, o vocabulário ou a arquitetura. A biblioteca rejeita temperatura zero ou negativa; para uma escolha determinística, use greedy=True em Python ou Mais provável na interface.
Sortear ou escolher o maior valor
| Opção | Cálculo do próximo ID | O que esperar |
|---|---|---|
| Sortear | Sorteia segundo a distribuição p |
Rodadas iguais podem produzir continuações diferentes. |
| Mais provável | Usa o índice de maior probabilidade | Com os mesmos pesos e contexto, a escolha é reproduzível. |
A interface não expõe um campo de seed para o sorteio. Para reproduzir uma rodada amostrada em Python, forneça seed a GlassLM.generate. O modo greedy não precisa de seed para escolher o ID.
Para um mesmo vetor de logits e temperatura positiva, dividir por T conserva a ordem dos candidatos. Portanto, mudar somente a temperatura em greedy altera a distribuição exibida, mas não o ID de maior valor. A continuação pode mudar quando você usa sorteio, pois as chances de cada ID mudam.
Quando os ajustes passam a valer
Temperatura e método de escolha são enviados ao worker quando ele cria o gerador da rodada. Pausar, mover o slider e retomar não cria esse gerador novamente. O painel pode mostrar a posição nova do controle enquanto o gerador existente ainda usa o valor inicial.
Para comparar as configurações corretamente:
- Pause e clique em Limpar.
- Mantenha o mesmo prefixo.
- Selecione temperatura e método de escolha.
- Use Um passo e anote candidato, probabilidade e ID escolhido.
- Limpe e repita com o outro ajuste.
Não conclua que o slider não funciona apenas porque a escolha greedy permaneceu igual. Compare as probabilidades e a concentração da distribuição.
Dois relógios diferentes
O Intervalo entre tokens define uma espera de apresentação depois do fluxo de uma previsão: Lenta, 650 ms; Normal, 300 ms; Rápida, 90 ms. O intervalo é lido entre avanços e pode mudar na rodada existente. Ele não altera o resultado das contas nem garante uma taxa exata de tokens por segundo; tempo de cálculo e animação se somam à espera.
Tempo por cálculo pertence ao slow motion e oferece 1, 2, 3, 5 ou 8 segundos entre os snapshots, com padrão de 3 segundos. Uma previsão de 77 eventos envolve 76 esperas quando reproduzida integralmente. O objetivo desse controle é permitir leitura de cada operação antes da próxima, não definir quantos tokens o modelo calcula por segundo.
Estado do modelo e privacidade
O painel mostra o último token e informa carregamento, execução, pausa ou limite da rodada. No primeiro uso há downloads do runtime e do wheel. Depois, a inferência ocorre localmente em um Web Worker com a biblioteca NumPy; a frase é enviada a esse worker, não a uma API de inferência remota.
Se um ajuste parecer não surtir efeito, confira se você iniciou uma rodada nova. Se a interface informar falha, abra Detalhes técnicos e consulte estados e erros. Para interpretar as seis barras da saída, continue em atenção e probabilidades.