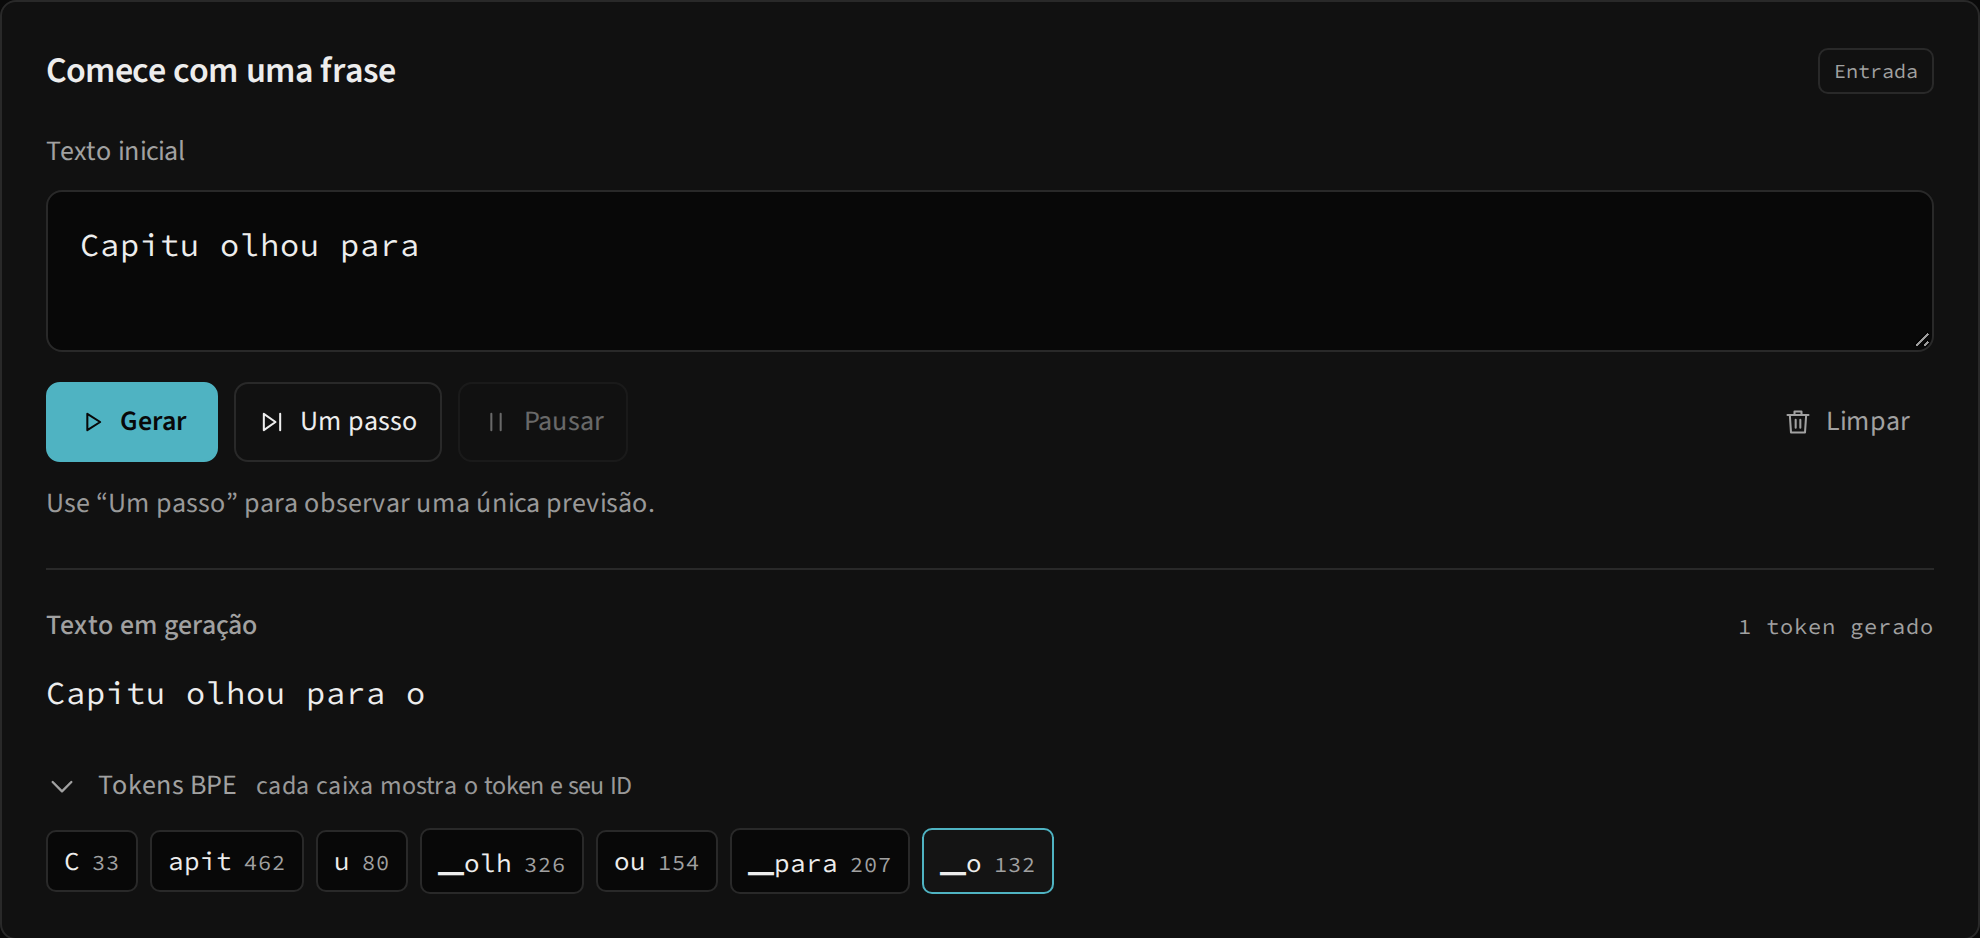
Do texto inicial à continuação
O campo Texto inicial aceita até 600 caracteres. O tokenizer transforma a frase em IDs do vocabulário do idioma. Esse limite de caracteres é diferente da janela do modelo: a geração usa os últimos 128 tokens de entrada quando o prefixo é maior que o contexto.
Ao iniciar uma rodada, Texto em geração recebe o prefixo escrito. Cada previsão acrescenta a decodificação do ID escolhido, e o contador acompanha apenas tokens gerados, não tokens do prefixo. Um token BPE pode ser uma letra, parte de uma palavra, uma palavra com espaço inicial ou pontuação; ele não corresponde necessariamente a uma palavra inteira.
Efeito de cada botão
| Controle | Comportamento |
|---|---|
| Gerar | Cria uma rodada se não houver uma ativa; caso contrário, retoma o gerador existente. Continua até pausa ou até o limite de 128 tokens novos. |
| Um passo | Produz uma previsão e deixa a rodada pausada. Com slow motion e um fluxo incompleto, primeiro conclui a reprodução pendente da mesma previsão. |
| Pausar | Interrompe a continuidade e a reprodução. Mantém texto, gerador e último trace. Uma conta NumPy já em andamento pode terminar antes da pausa se efetivar. |
| Limpar | Descarta a rodada exibida, IDs, candidatos e seleção de valores. Preserva a frase no editor, os ajustes e o runtime já carregado. |
Enquanto uma ação calcula ou reproduz o fluxo, os controles que poderiam iniciar outra ação ficam desabilitados. Pausar permanece disponível quando há geração ou reprodução ativa. Aguarde a ação liberar Limpar antes de reiniciar o experimento.
Editar não é reiniciar
Ao pausar, o editor volta a ficar disponível. Entretanto, a rodada já criada guarda os IDs do prefixo original. Editar o campo e pressionar Gerar continua essa rodada; o gerador não retokeniza o campo a cada clique.
Para testar outra frase ou outra configuração de escolha, use esta sequência:
- Pause a execução e aguarde os botões voltarem a responder.
- Clique em Limpar.
- Edite o prefixo e escolha os ajustes.
- Clique em Um passo ou Gerar para criar uma rodada nova.
Ao atingir 128 tokens novos, a rodada termina. Um clique posterior inicia outra rodada a partir da frase que está no editor, sem transformar automaticamente a saída anterior em um prefixo novo.
Ler as caixas BPE
Cada caixa exibe a forma do token no vocabulário e seu ID. O marcador ▁ representa espaço: ▁para decodifica como para. Quebras de linha aparecem como ↵ no painel. O marcador de desconhecido <unk> decodifica como ⁇; <pad>, <bos> e <eos> não acrescentam texto visível ao decodificar.
O gerador não encerra automaticamente ao produzir <eos>. Assim, o contador pode aumentar sem aparecer um novo caractere na saída. Isso é um comportamento do motor atual, não uma falha do painel de texto.
Ao iniciar, o painel lista os tokens do prefixo. Após cada previsão, limita a exibição aos últimos 64 tokens, para manter a área legível. Essa seleção visual não reduz a janela de 128 tokens do modelo. Último token mostra a forma BPE escolhida, enquanto a saída usa sua decodificação.
O que acontece dentro do motor
GlassLM.generate cria um gerador Python. No primeiro avanço, calcula o prefixo e preenche o cache K/V de cada bloco. Nos seguintes, calcula geralmente apenas o token novo, reutilizando chaves e valores anteriores. Quando a janela enche, reconstrói o cache a partir dos últimos 128 IDs.
Cada avanço entrega um GenStep e um trace novo. Os painéis de atenção, probabilidades e arquitetura passam a representar esse avanço mais recente. Para rever a mesma previsão, use Reproduzir fluxo; para comparar escolhas entre rodadas, veja temperatura e escolha e tokens e BPE.