Do texto aos IDs
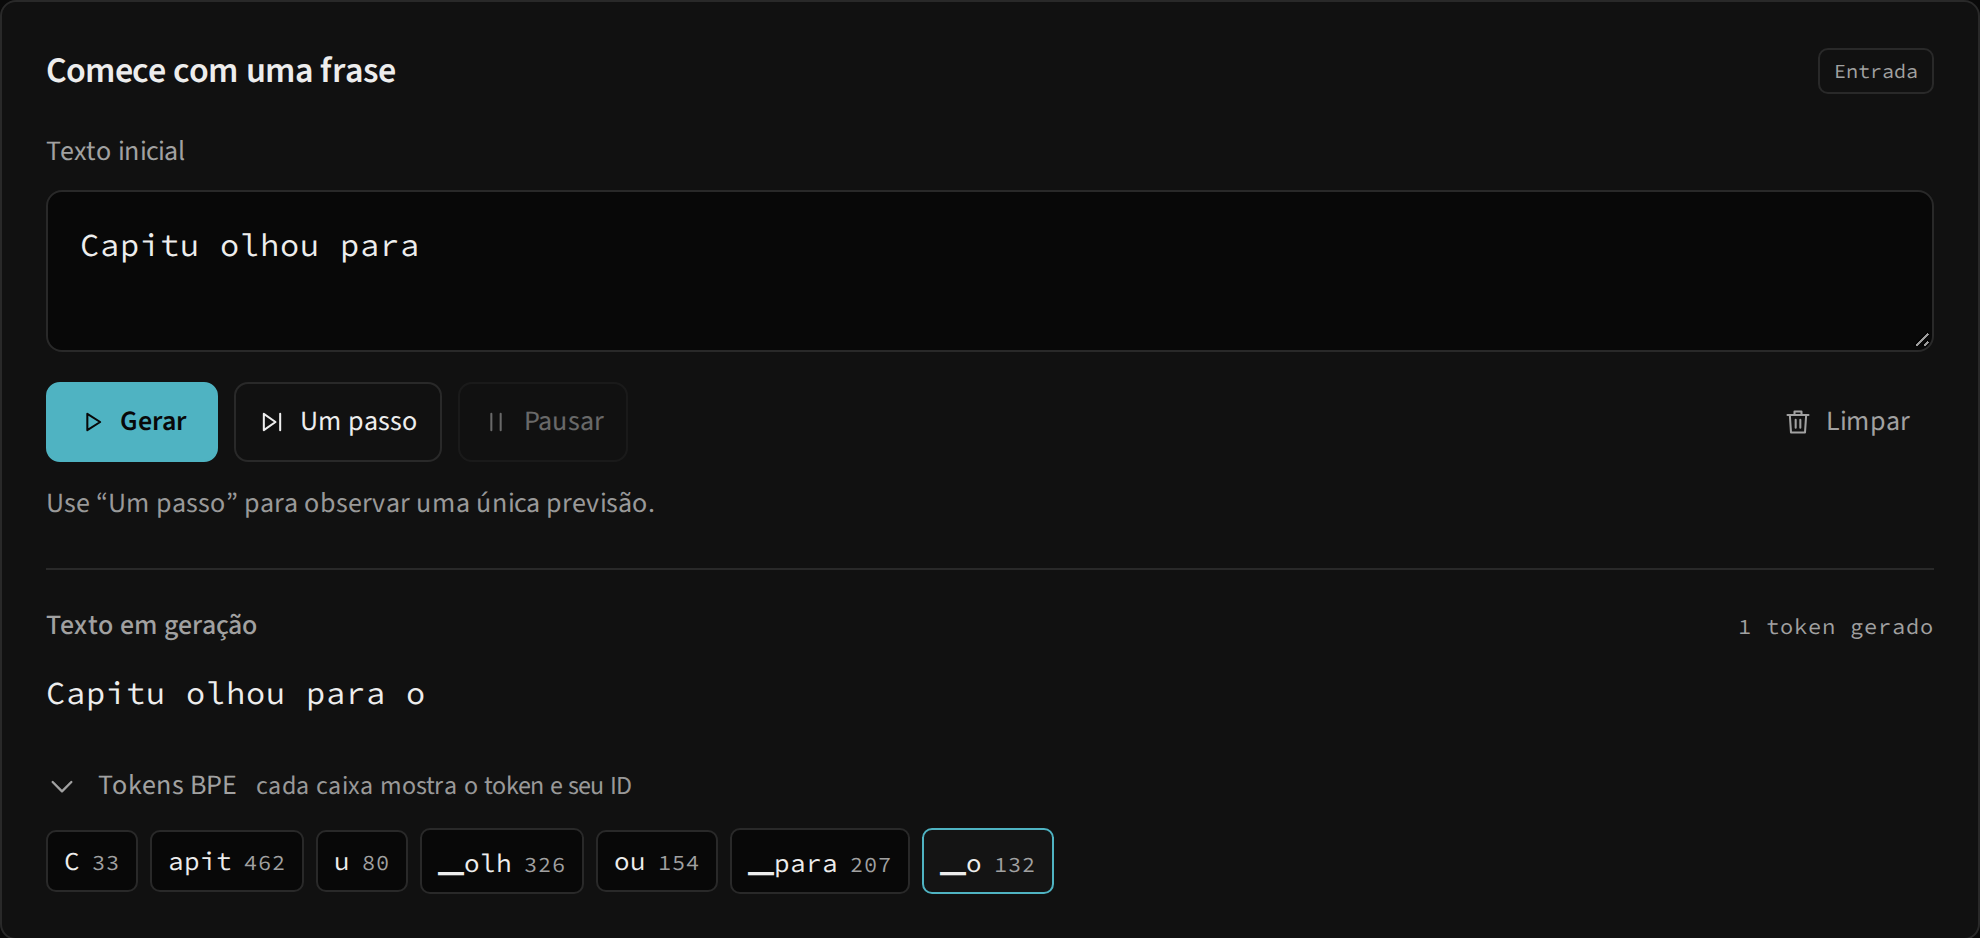
O Transformer recebe números inteiros. Cada ID identifica uma entrada do vocabulário: uma letra, uma pontuação, uma subpalavra ou uma palavra que apareceu durante o aprendizado das fusões. Um token não corresponde necessariamente a uma palavra nem a um byte.
O glassllm implementa BPE sobre caracteres Unicode, em src/glassllm/tokenizer.py. Não utiliza a biblioteca SentencePiece e não tem o mecanismo de fallback por bytes de outros tokenizers. Os modelos de português e inglês possuem vocabulários diferentes de 1.024 entradas. O mesmo ID pode representar textos diferentes em cada idioma.
Texto → normalização NFC → chunks → fusões BPE → peças → IDs
IDs → peças → remoção de especiais → ▁ vira espaço → texto
Normalização e fronteiras
pre_tokenize(text) primeiro normaliza Unicode para NFC: uma letra e seu acento combinante são tratados como a forma composta equivalente. Depois troca o espaço comum por ▁ e separa chunks com uma expressão regular. Os espaços antes de uma palavra podem fazer parte de seu chunk; uma quebra de linha forma um chunk próprio. As fusões não atravessam essas fronteiras.
Por exemplo, pre_tokenize("Era uma vez\n") produz ['Era', '▁uma', '▁vez', '\n']. O marcador ▁ torna o espaço visível no painel de tokens. Ele não é uma letra adicional no texto decodificado.
| Token especial | ID fixo | Decodificação |
|---|---|---|
<pad> |
0 | Omitido |
<unk> |
1 | ⁇ |
<bos> |
2 | Omitido |
<eos> |
3 | Omitido |
encode não acrescenta automaticamente BOS ou EOS. Caracteres desconhecidos tornam-se <unk>; portanto a decodificação não recupera um caractere ausente do alfabeto. NFC também significa que a representação Unicode original nem sempre é preservada byte a byte.
Como as fusões são aprendidas
Tokenizer.train(text, vocab_size) conta os chunks e seus pares adjacentes. Em cada rodada, escolhe o par mais frequente, substitui ocorrências sem sobreposição e registra a fusão. Empates são resolvidos pela ordem alfabética dos pares, tornando o treinamento determinístico para o mesmo texto.
O vocabulário inicial contém os quatro especiais e o alfabeto observado. Cada fusão acrescenta uma entrada. Se não houver mais pares, o treinamento termina antes do tamanho solicitado. Pedir menos entradas que especiais mais alfabeto lança ValueError.
Na codificação, a ordem aprendida das fusões decide qual par é aplicado primeiro. Não basta procurar a subpalavra mais longa no vocabulário: ranks conserva a prioridade de cada fusão.
Exemplo reproduzível
Este exemplo utiliza um corpus pequeno para permitir conferir todas as etapas:
from glassllm import Tokenizer

t = Tokenizer.train("banana banana", vocab_size=12)
print(t.merges)
print(t.encode("banana banana"))
print(t.encode_verbose("banana")[0]["steps"])
print(t.decode(t.encode("banana banana")))
Saída verificada:
[('a', 'n'), ('an', 'a'), ('an', 'ana'), ('b', 'anana')]
[11, 7, 11]
[['b', 'a', 'n', 'a', 'n', 'a'],
 ['b', 'an', 'an', 'a'], ['b', 'an', 'ana'],
 ['b', 'anana'], ['banana']]
banana banana
O espaço do segundo chunk permanece separado porque não há fusão aprendida para ('▁', 'banana'). Nesse tokenizer, t.encode("🙂") retorna [1].
Relação com a interface e o motor
Com o tokenizer português distribuído no projeto, "Era uma vez" corresponde a [35, 120, 219, 373], com peças ['E', 'ra', '▁uma', '▁vez']. Use tokens(ids) para consultar as peças e decode(ids) para ler o texto; não existe id_to_token nessa API.
O painel de tokens mostra esses IDs. O próximo estágio, embed, usa cada ID para consultar uma linha de E. As fusões podem ser acompanhadas com encode_verbose; elas não são snapshots do Tracer, que começa dentro do modelo.
Referências e limites
O uso de unidades subpalavra com BPE é discutido por Sennrich, Haddow e Birch em Neural Machine Translation of Rare Words with Subword Units, primeiro preprint de 2015. O artigo SentencePiece, de Kudo e Richardson, 2018, oferece contexto para a representação explícita de espaços; esta implementação mantém suas próprias regras de chunks, normalização e fusões. Os resultados dos artigos não são avaliações deste pequeno modelo.