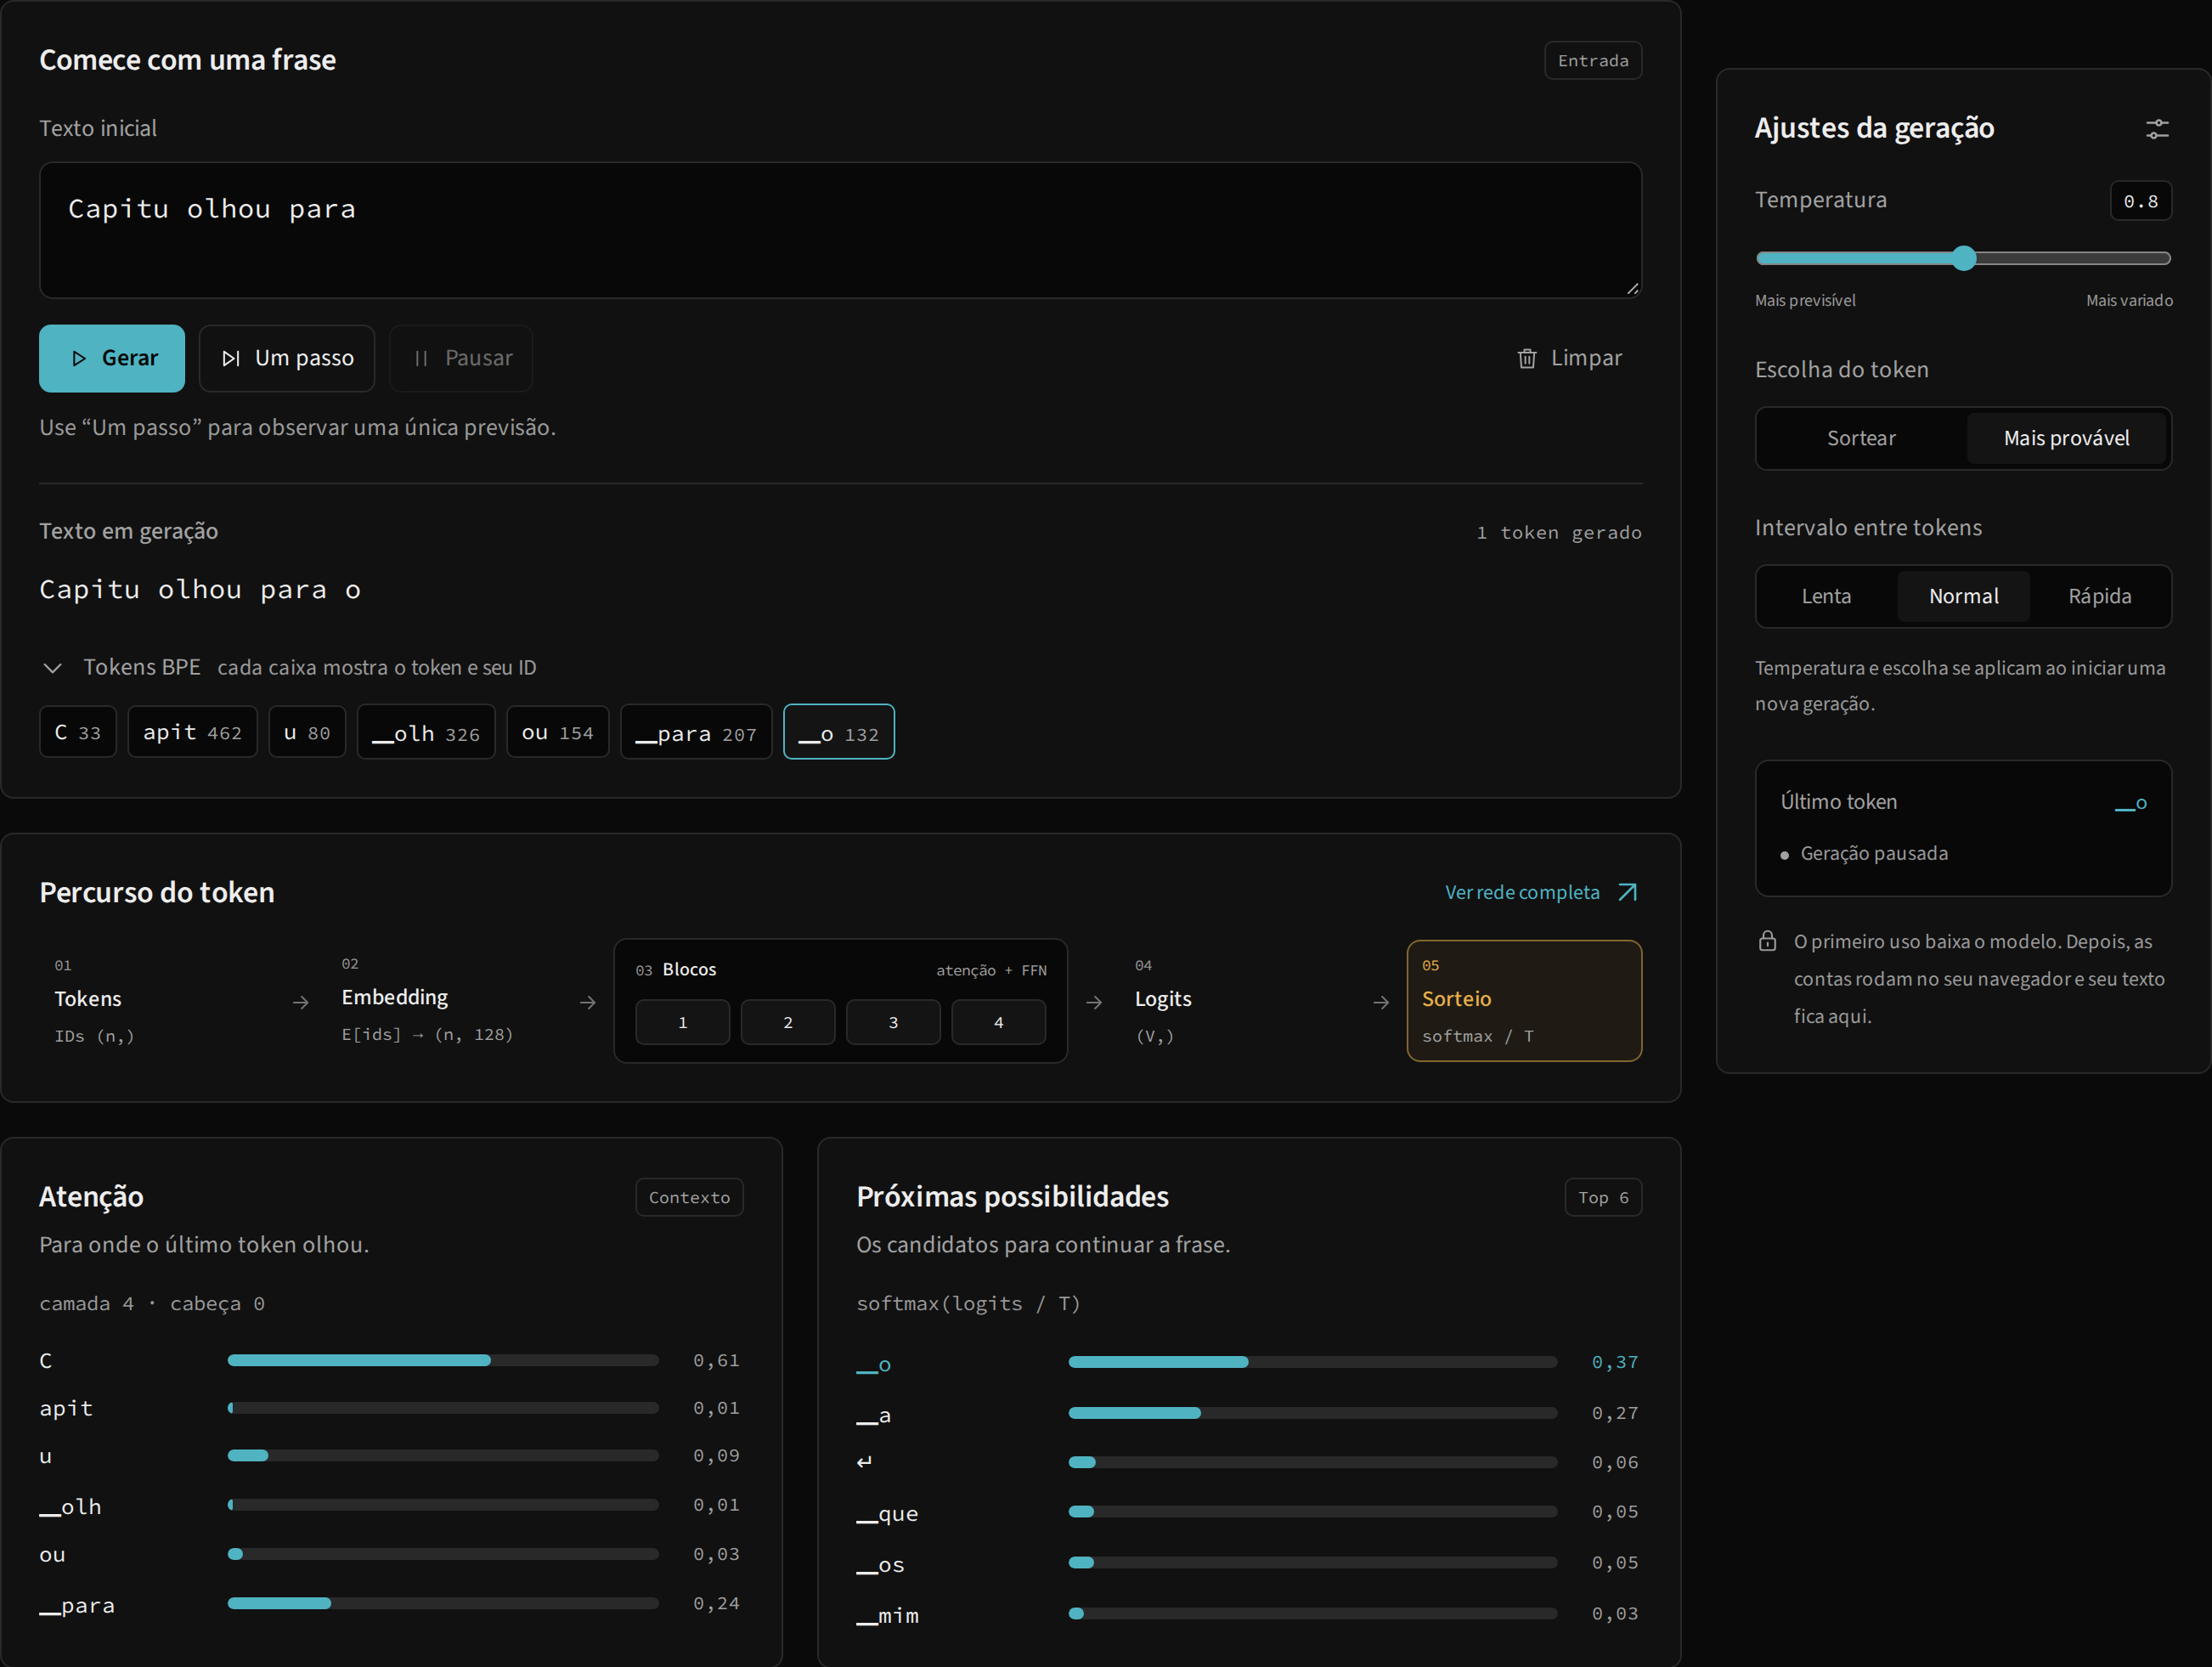
Uma frase, uma previsão, contas visíveis
O glassllm é um Transformer pequeno escrito em Python e NumPy para estudar como um modelo de linguagem funciona. Você fornece um início de frase; o modelo calcula uma distribuição sobre seu vocabulário, escolhe um ID e acrescenta esse token ao contexto. Ao repetir o processo, produz uma continuação.
O laboratório mostra o mesmo motor usado pela biblioteca Python. As matrizes, probabilidades e etapas do desenho vêm da execução do modelo para a sua frase. Não são valores ilustrativos. Cada cálculo marcado possui uma equação, um snapshot do resultado e a localização da expressão no código-fonte.
As três partes do projeto
| Parte | O que faz | Como explorar |
|---|---|---|
Biblioteca glassllm |
Tokenização BPE, autograd, Transformer, geração, rastreamento e treinamento | Python e CLI |
| Modelos PT e EN | Pesos aprendidos e tokenizer próprio de cada idioma | load_pretrained("pt") ou load_pretrained("en") |
| Laboratório | Executa o wheel Python em um worker Pyodide e apresenta os resultados | Editor, atenção, candidatos e arquitetura |
No navegador, a sequência é texto → IDs BPE → embedding → quatro blocos → normalização final → logits → probabilidades → token escolhido. O ID escolhido volta diretamente ao contexto, sem ser tokenizado novamente. No primeiro uso, o navegador baixa o runtime, o NumPy e o wheel; o cálculo da frase ocorre no worker local, sem uma chamada a um serviço de inferência.
O modelo que você está observando
Os assets incluídos usam vocabulário de 1.024 tokens, vetores de 128 dimensões, quatro blocos, quatro cabeças Q e duas cabeças K/V. Cada cabeça tem 32 dimensões. A janela de contexto comporta 128 tokens e a FFN SwiGLU tem dimensão interna 341. A matriz de embedding também projeta a saída, totalizando 852.608 parâmetros aprendidos.
É um decoder causal: cada posição observa apenas as posições permitidas pela máscara. Ele usa RMSNorm antes da atenção e da FFN, RoPE em Q e K, GQA e cache K/V. A biblioteca explica e expõe essas operações individualmente; o mapa reúne suas relações.
Os modelos são pequenos e treinados em textos literários. Podem repetir palavras, perder coerência e gerar tokens especiais sem texto visível. Não são assistentes de instruções nem ferramentas para respostas factuais. A finalidade é acompanhar cálculos e testar hipóteses sobre o mecanismo.
Escolha seu primeiro percurso
Para explorar sem programar, abra o laboratório, selecione Mais provável e use Um passo. Compare o token escolhido com o painel de candidatos e depois abra a arquitetura. O primeiro experimento conduz essa sequência e reproduz a mesma previsão em Python.
Para usar o motor diretamente, siga a instalação local e a referência da biblioteca. Para aprender a ler o desenho, comece pelo mapa dos componentes e pelos fundamentos de atenção.
O que um registro representa
Uma previsão com os quatro blocos registra 77 eventos: embedding; 18 operações em cada bloco; normalização final; logits; probabilidades; escolha. Isso não significa 77 funções independentes nem 77 eventos por cabeça. Um registro de atenção pode guardar todas as cabeças e permitir selecionar uma delas depois.
O laboratório mantém o trace da previsão mais recente. O modo slow motion percorre os snapshots já calculados, selecionando equação, valores e nó correspondente. Ele oferece tempo de leitura, mas não modifica as contas NumPy nem guarda um histórico de todas as previsões.