Produzir uma previsão que você consegue comparar
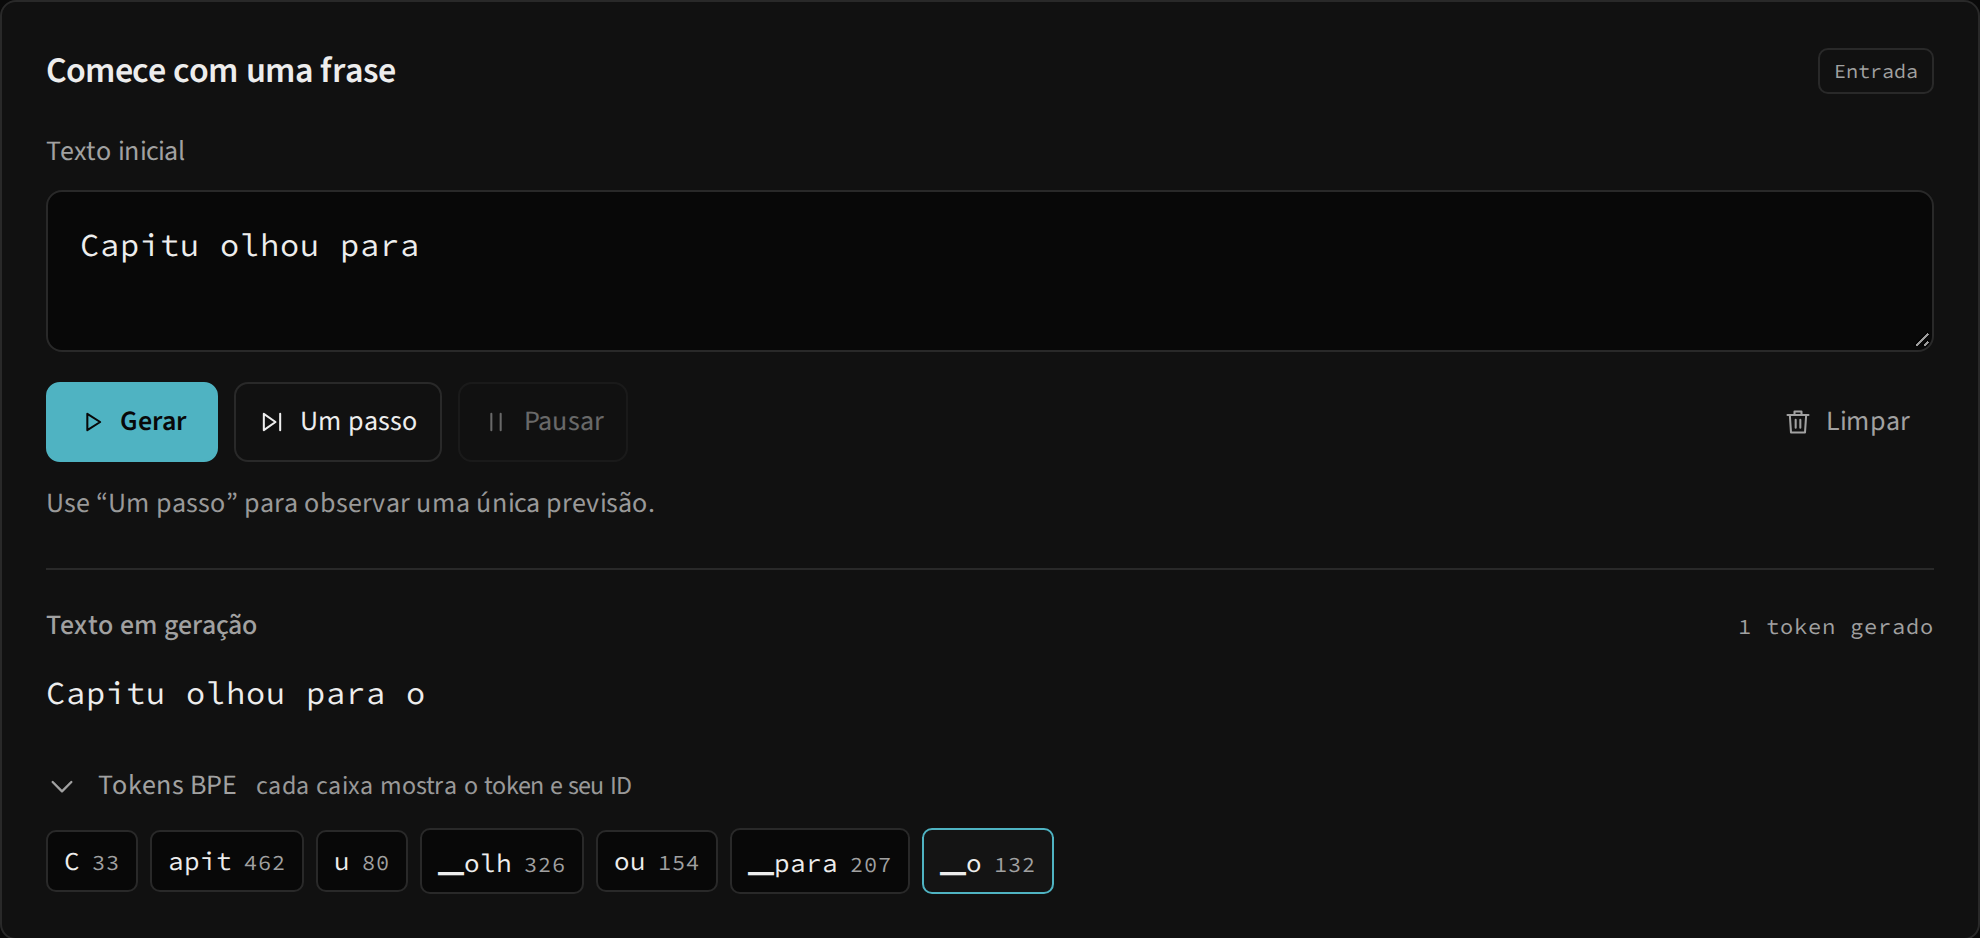
Use a mesma frase, o mesmo idioma e a escolha determinística nos dois ambientes. O laboratório em português abre com Capitu olhou para; o inglês abre com Alice was beginning to. O tokenizer de cada modelo é diferente, portanto não reutilize IDs de um idioma no outro.
- Abra o laboratório e mantenha a frase inicial.
- Em Escolha do token, marque Mais provável. Mantenha a temperatura em
0.8. - Clique em Um passo e aguarde o carregamento inicial.
- Leia o Último token, a continuação e as caixas de Tokens BPE.
- Compare Atenção com Próximas possibilidades. Um painel descreve o contexto; o outro descreve a saída.
Com os assets incluídos, a frase PT gera seis IDs: 33, 462, 80, 326, 154, 207, correspondentes a C, apit, u, ▁olh, ou, ▁para. A próxima escolha greedy é o ID 132, exibido como ▁o e decodificado como o. Esses resultados foram conferidos com os pesos do checkout; retreinar ou substituir os assets pode mudá-los.
Repetir a previsão em Python
Depois da instalação, salve e execute este código com uv run python arquivo.py:
import numpy as np
from glassllm import load_pretrained

model, tokenizer = load_pretrained("pt")
ids = tokenizer.encode("Capitu olhou para")
step = next(model.generate(
    ids, n_new=1, temperature=0.8, greedy=True, trace=True
))

print(ids)
print(tokenizer.tokens(ids))
print(step.token, repr(tokenizer.decode([step.token])))
print(len(step.trace.records))
assert np.isclose(step.probs.sum(), 1.0)

attention = step.trace.get("attn.softmax", layer=3, head=0)
print(attention.shape)
print(attention.value[-1])
assert np.allclose(attention.value.sum(axis=-1), 1.0)
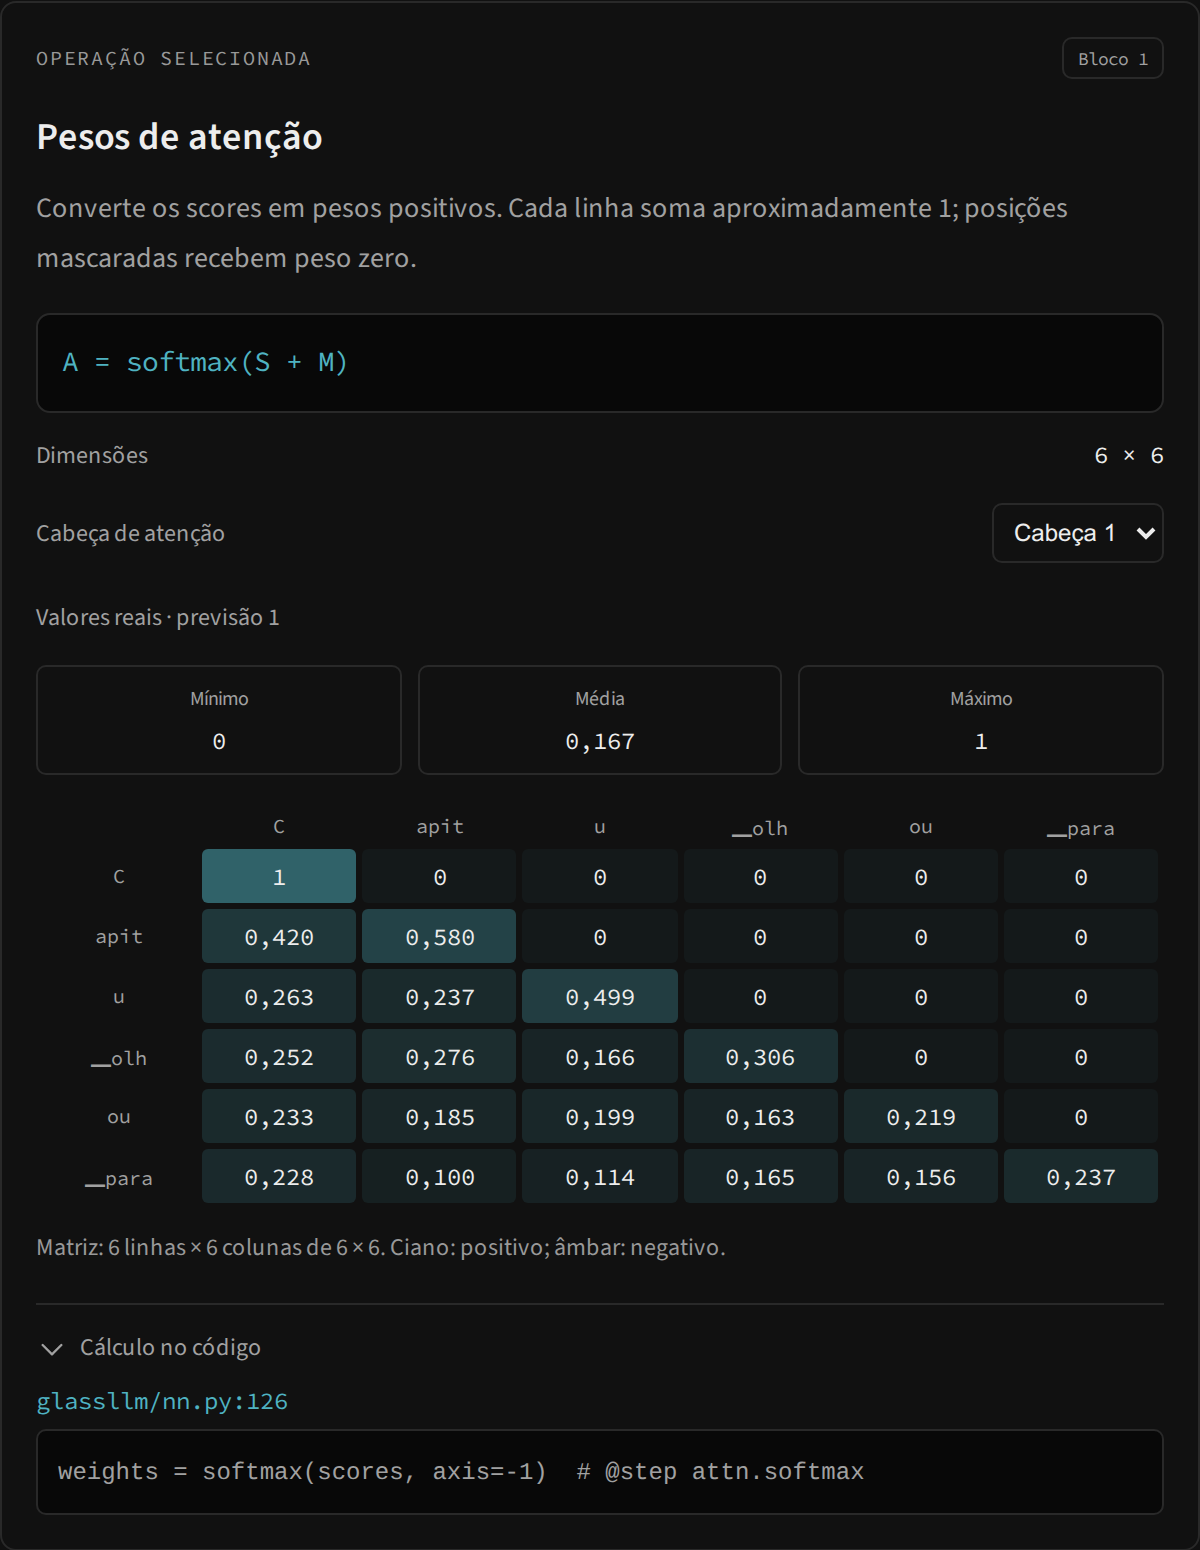
O GenStep contém o ID escolhido, a distribuição completa de saída e o trace da previsão. Para essa frase, são 77 registros e a atenção de uma cabeça tem formato (6, 6). layer=3 é o quarto bloco; head=0 é a primeira cabeça. O painel resumido do laboratório usa justamente a última linha dessa matriz.
Para repetir em inglês, troque o carregamento para "en" e a frase para "Alice was beginning to". Os assets incluídos produzem cinco tokens de entrada e a próxima escolha greedy tem ID 97, decodificada como the. Não compare o significado numérico dos IDs entre vocabulários.
Conferir um cálculo no desenho
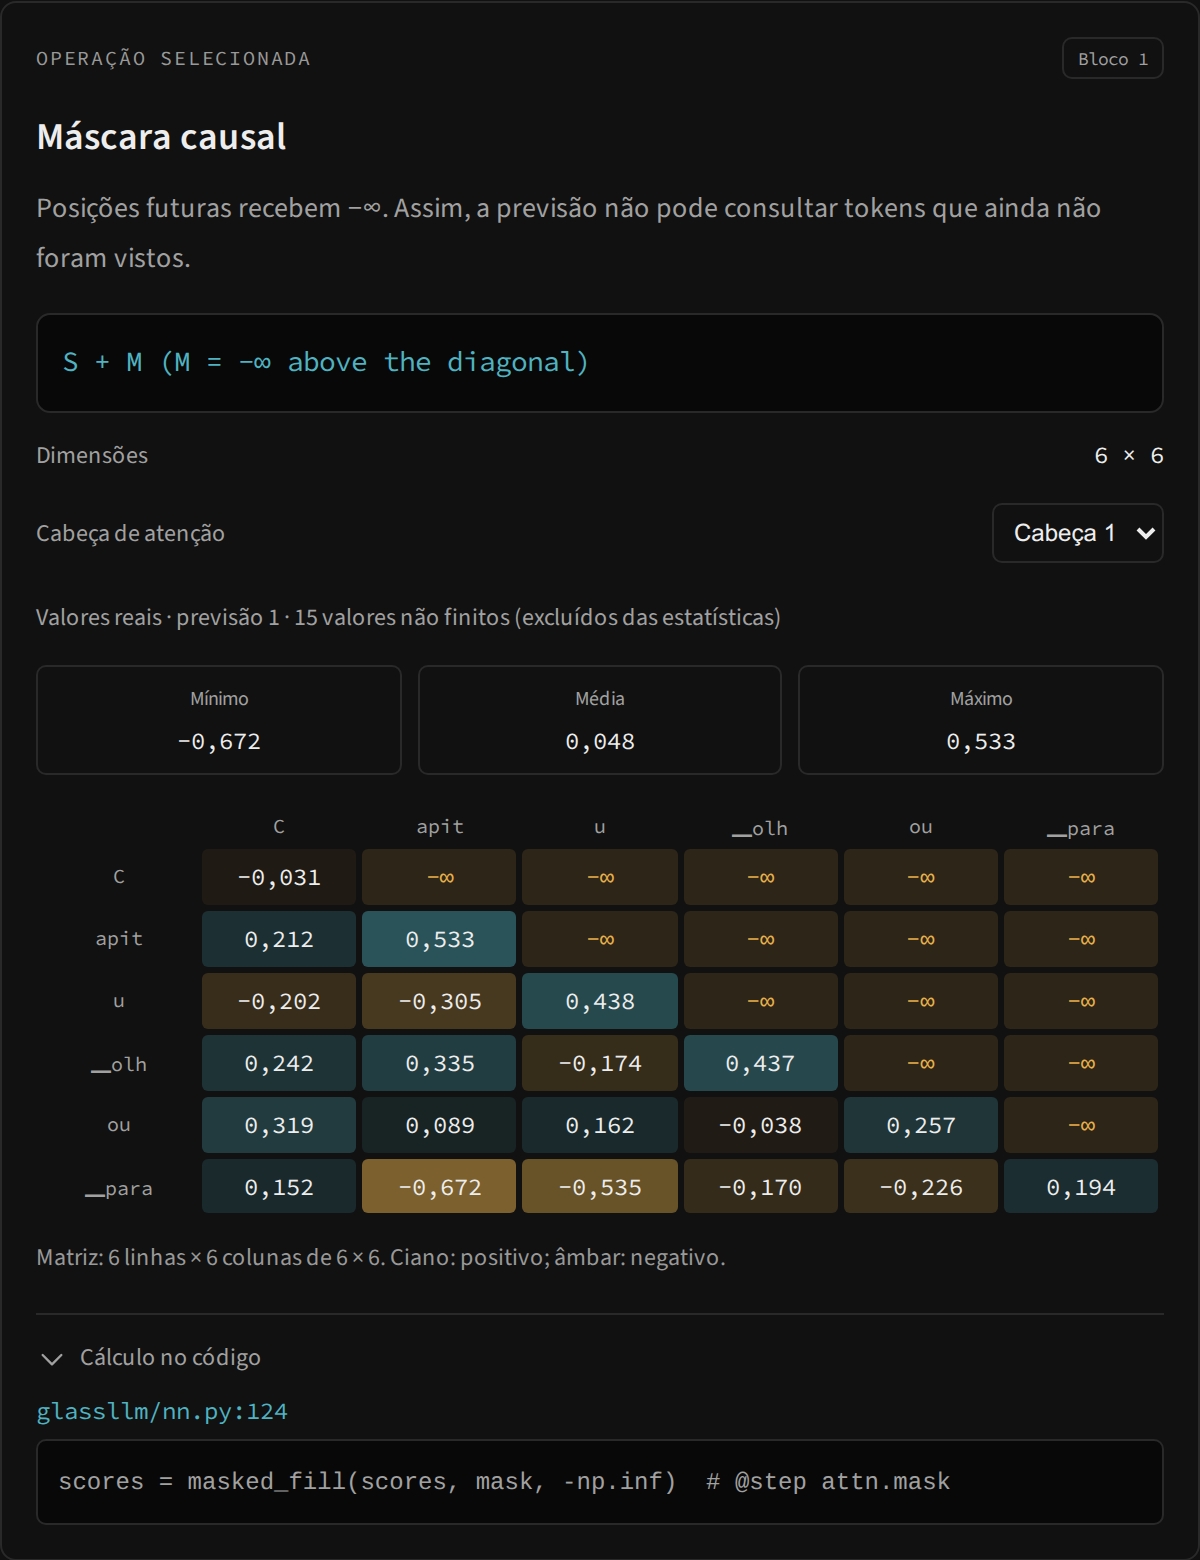
Abra Ver rede completa, vá a Bloco 1 e selecione Máscara causal. O inspetor mostra a equação, dimensões, valores e a linha que aplica a máscara. Na primeira previsão, o prefixo inteiro é calculado; posições futuras na matriz recebem −∞.
Você pode verificar o mesmo tensor sem iniciar uma geração:
from glassllm import Tracer

tracer = Tracer()
model.forward(ids, trace=tracer)
mask = tracer.get("attn.mask", layer=0, head=0)
print(mask.equation)
print(mask.value)
O forward registra logits e operações internas, mas não registra escolha nem a distribuição de geração: essas duas etapas pertencem a generate. No exemplo PT, a máscara de uma cabeça contém 15 posições −∞, acima da diagonal. Após softmax, essas posições recebem peso zero.
Estudar sem perder a previsão atual
Ative Slow motion e clique em Reproduzir fluxo. Use Pausar fluxo ao chegar a uma operação interessante; Cálculo anterior e Próximo cálculo percorrem os mesmos registros. Nenhuma nova previsão é necessária para rever o tensor.
Quando você gerar outro token, os painéis passam a representar a previsão nova. Nas etapas com cache, a consulta geralmente tem apenas uma posição, e a matriz de atenção passa a ser 1 × m. Para um ensaio limpo com outra frase ou outro método de escolha, clique em Limpar, edite a entrada e inicie novamente. Continue em slow motion e inspetor.